1. 서론
도시공원과 한강, 하천 같은 수변 공간은 여가와 경관 감상, 일상적 쾌적함 등 시장에서 직접 거래되기 어려운 편익을 제공한다. 최근 연구 리뷰는 공원과 녹지가 주택가격에 미치는 영향이 대체로 긍정적이면서도, 측정 방식과 도시 맥락에 따라 결과가 크게 달라질 수 있음을 정리한다(Chen et al., 2022). 고밀도 도시에서 신규 공원 조성이 인근 주택가격에 프리미엄을 만들 수 있다는 실증도 보고되고 있으나(Feng et al., 2024), 동시에 공원에 매우 가까운 입지가 혼잡 등 부정적 요인과 겹치면 가격이 오히려 낮아질 수 있다는 결과도 나타난다(Liu et al., 2024). 이처럼 최근 문헌은 ‘공원은 항상 집값을 올린다’는 단순 공식보다, 어떤 지표로 어떤 도시 구조에서 측정하는지가 결과를 좌우함을 보여준다.
헤도닉 가격모형은 주택을 여러 속성의 묶음으로 보고, 관측 가능한 실거래가격에서 각 속성의 암묵가격을 추정하는 표준 방법이다(Rosen, 1974). 도시 오픈스페이스의 가치를 종합한 메타분석은 대체로 양의 관계를 보고하면서도 녹지 유형, 밀도, 연구 설계에 따른 차이를 강조한다(Brander and Koetse, 2011). 도시 녹지와 수변 공간의 경제적 가치를 함께 다룬 메타분석 역시 자연 기반 요소의 경제적 가치를 지지한다(Bockarjova et al., 2020). 녹지 유형을 세분하면 일부 유형만 가격에 일관되게 반영된다는 연구(Panduro and Veie, 2013; Czembrowski and Kronenberg, 2016)와, 국내에서 공원 유형과 계획에 따라 효과가 달라진다는 연구(Kim et al., 2019; 김혜림과 홍성조, 2021)는 단일 거리 지표에만 의존한 해석의 한계를 뒷받침한다.
국내 실증에서도 근린공원 접근성과 아파트 가격의 관계가 다수 확인된다. 여러 근린공원에 대한 접근성과 그 상호작용을 분석한 연구(구한민과 김갑성, 2020), 서울숲 조성이 인근 주택가격에 미친 영향(신상영 등, 2006), 한강변 입지와 층수의 결합 효과(배상영 등, 2018) 등은 공원과 수변 공간이 서로 다른 경로로 가격에 반영될 수 있음을 보여준다. 따라서 한강처럼 가격 영향이 큰 입지 요인과 공원이 같은 지역에 겹쳐 배치되면, ‘가장 가까운 공원까지의 거리’만으로는 공원의 효과를 명확히 분리하기 어렵다. 거리값이 공원만이 아니라 강변 입지나 대단지 배치 같은 다른 요인을 함께 반영할 수 있기 때문이다.
선행연구는 공원의 유형과 규모 및 입지 맥락에 따라 주택가격과의 연관이 달라질 수 있음을 이미 보여 주었다(Brander and Koetse, 2011; Czembrowski and Kronenberg, 2016; Kim et al., 2019; Liu et al., 2024). 따라서 최근접 거리 지표의 일반적인 한계를 발견한 것 자체를 본 연구의 신규성으로 제시하지 않는다. 본 연구에서는 같은 자료와 통제변수를 사용하는 경우에도 추론 단위, 거래량에 따른 관측 비중, 공간 의존을 다루는 모형, 접근성 지표의 정의가 서로 다른 비교를 형성한다는 점에 주목하였다. 점추정은 같지만 불확실성만 달라지는 경우와 가중 방식 또는 모형의 제약으로 추정대상이 달라지는 경우를 구분하였다.
헤도닉 연구는 일반적으로 주택 구조와 입지 변수를 함께 통제한다. 본 연구가 검토한 문제는 이러한 조건부 계수가 정책 해석 과정에서 공원 접근성의 경제적 가치로 단순화될 위험이다. 같은 단지에서 반복되는 거리 변수와 오차 의존(Moulton, 1990), 녹지 유형별 차이(Panduro and Veie, 2013), 수변 입지와의 공간적 중첩을 고려하여 계수가 무엇을 비교하는지 명시할 필요가 있다. 특정 국내 지침이나 연구 전체가 거리계수 하나만으로 편익을 평가한다는 주장은 하지 않는다.
본 연구는 공원거리와 한강거리의 단지 수준 상관이 양수인 동대문구와 음수인 성동구를 대조 사례로 검토하였다. 이러한 사례 선택은 사양 민감성을 관찰하기에 유리하므로 결과를 서울 전체나 다른 도시로 일반화하는 데 제약이 있다. 연구의 목적은 취약성의 보편적인 발생 빈도를 추정하는 것이 아니라 두 사례에서 어떤 분석 선택이 계수의 크기, 방향 및 불확실성과 관련되는지 구분하는 데 있다.
중심 연구 질문은 주택 구조와 입지를 통제한 최근접 공원거리와 가격의 연관이 추론, 가중 방식, 공간모형 및 지표 정의를 달리하였을 때 얼마나 유지되는가이다. 같은 점추정에서 군집 추론만 변경하는 비교, 거래와 단지의 비중을 바꾸는 비교, 동일 단지 단면의 공간모형 비교를 중심에 두었다. 수변 통제와 면적 접근성 정의는 해석 범위를 확인하는 보조 분석으로 두었으며, 시점 및 거리 간 상호작용은 탐색적 분석으로 구분하여 부록 1에 제시하였다.
제2장에서는 사례와 자료의 구성 및 추정 방법을 설명하였다. 제3장에서는 재구축한 공간변수의 기술통계와 가격모형의 추정 결과를 제시하였다. 제4장에서는 유지되는 연관과 사양에 따른 변화, 자료의 제약 및 정책 해석의 범위를 논의하였다.
2. 연구 방법
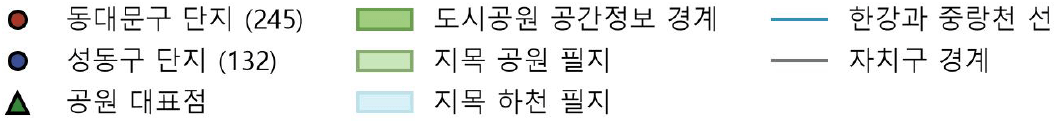
동대문구와 성동구는 서울 동부에서 공원과 수변 공간의 배치가 서로 다른 두 사례이다. 분석 표본은 동대문구 245개 단지 5,244건, 성동구 132개 단지 4,957건이다. 그림 1에는 단지 좌표, 공원 대표점과 공원 경계, 한강과 중랑천 및 자치구 경계를 공통 좌표계로 표시하였다. 모든 단지는 같은 크기의 원으로 표시하였고 색으로 자치구를 구분하였다. 삼각형은 공원 대표점으로 실제 출입구를 의미하지 않는다. 공원 경계와 지목이 공원인 필지는 서로 다른 자료이므로 범례에서 구분하였다.
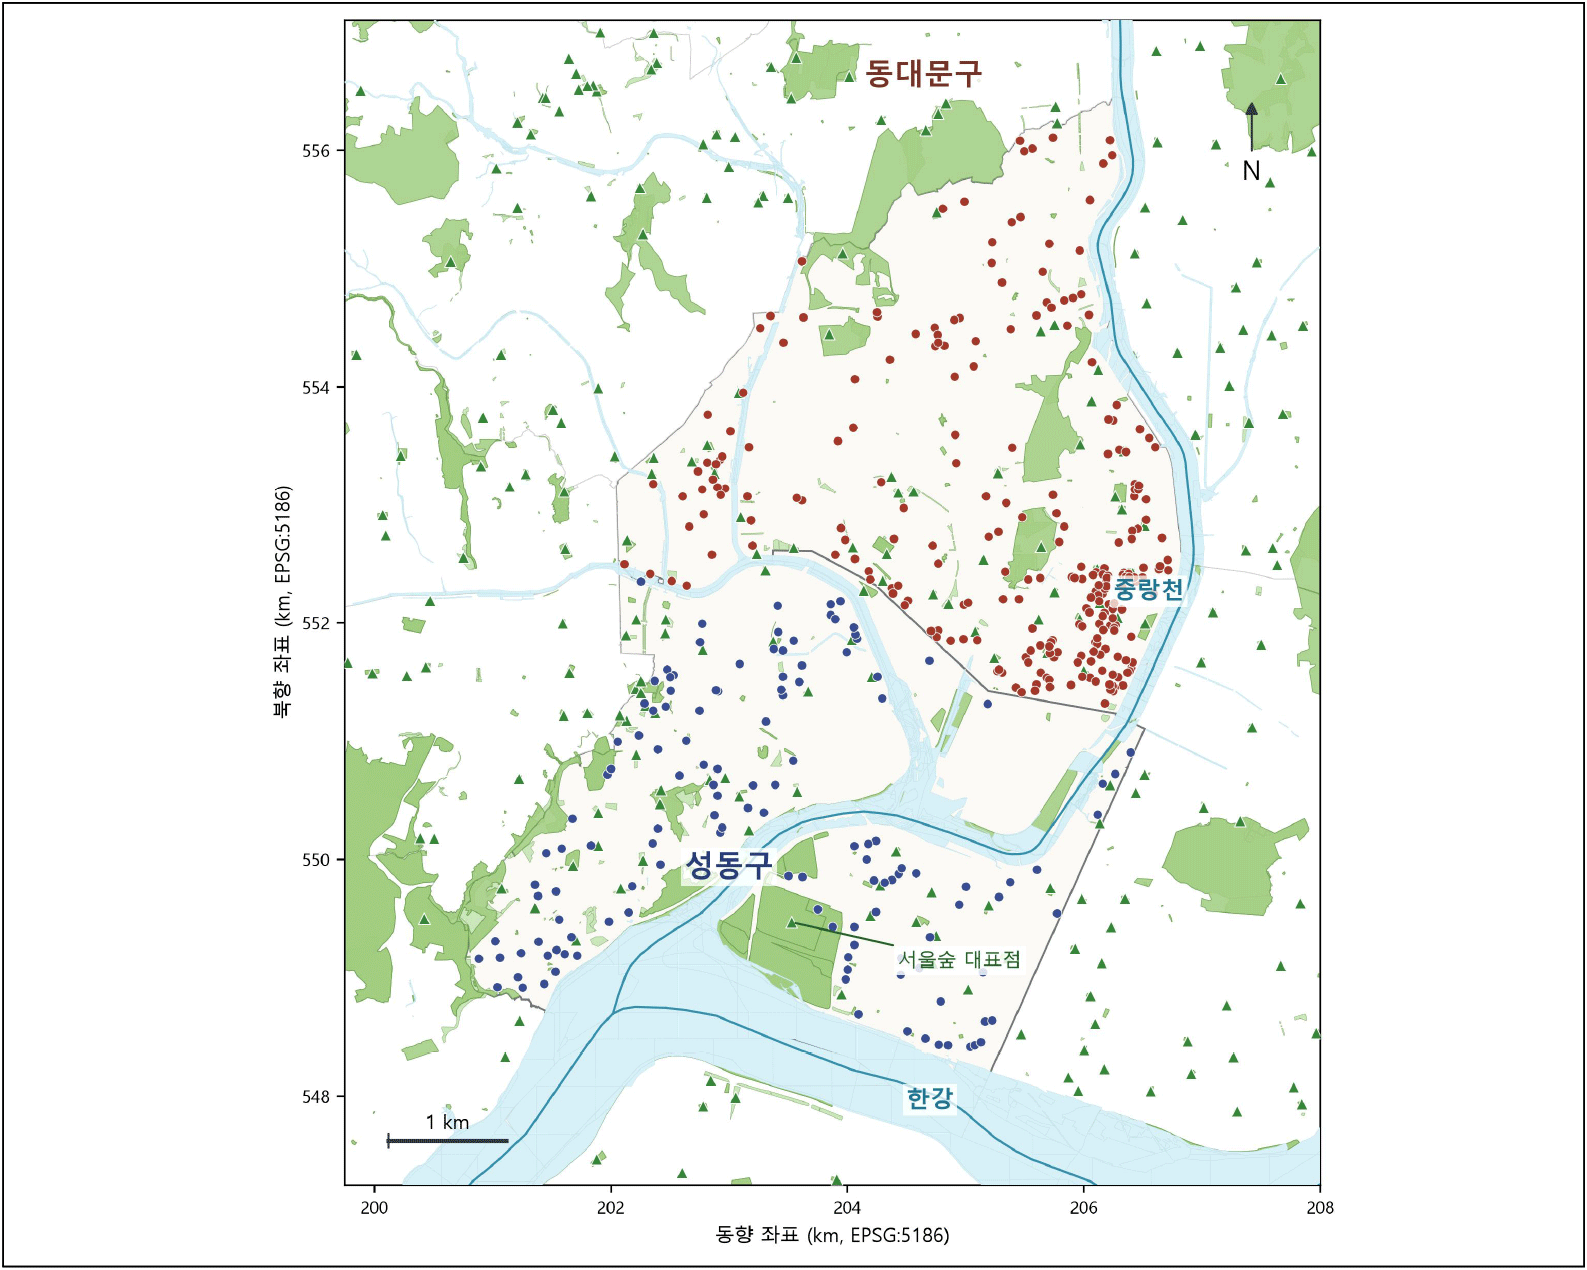
두 자치구는 공원거리와 한강거리의 상관 방향이 대조적인 사례로 선택되었다. 따라서 단순 상관만으로 가격계수의 원인을 확정하거나 다른 자치구에서 같은 결과가 발생할 것이라고 일반화하지 않았다. 수변 통제와 부분표본 분석은 가능한 설명의 범위를 검토하는 데 사용하였다.
거래자료는 국토교통부 실거래가 공개시스템의 아파트 매매자료에 기초하였다. 2014년과 2024년의 두 단면에 같은 분석 절차를 적용하였으며, 두 해를 선택한 것은 10년 간격의 비교 범위를 정한 것이다. 특정 정책의 전후 효과나 연속적인 시장 추세를 식별하는 설계로 해석하지 않았다. 최초 거래 11,817건에서 정비사업 단지의 거래 1,614건과 세대 수를 확인할 수 없는 2건을 제외한 10,201건을 최종 표본으로 하였다(표 1 참조).
| 자치구 | 연도 | 최초 거래 | 정비사업 제외 | 세대 수 미조회 | 최종 거래 |
|---|---|---|---|---|---|
| 동대문구 | 2014 | 3,141 | 95 | 0 | 3,046 |
| 2024 | 2,496 | 298 | 0 | 2,198 | |
| 성동구 | 2014 | 3,294 | 304 | 2 | 2,988 |
| 2024 | 2,886 | 917 | 0 | 1,969 | |
| 합계 | 11,817 | 1,614 | 2 | 10,201 | |
*최초 거래 수는 실거래가 공개시스템에서 내려받은 자료의 건수이고 제외 건수는 단지별 제외 목록의 합산값이다. 해제 거래와 중복 거래의 처리 건수는 이 표에 포함하지 않았다.
정비사업 단지는 사업시행계획인가 이후 단계를 기준으로 작성한 단지별 제외 목록에 따라 제외하였다. 이 목록에는 신속통합기획, 조합청산, 조합해산 및 준공인가 단계의 단지도 포함되어 있으며, 2024년에 사업시행계획인가 단계로 분류된 단지는 2014년 거래도 제외하였다. 따라서 제외 단지가 거래 당시 모두 같은 사업 단계였다고 가정하지 않고, 이 목록에 해당하는 단지를 제외한 표본으로 정의하였다.
단지 세대 수는 한국부동산원 단지 식별정보 기본정보를 우선 사용하고 누락값은 네이버 부동산으로 보완하였다. 네이버 부동산으로 보완한 단지는 동대문구 5개와 성동구 10개이며, 보완값은 2025년 12월 조회 기준으로 거래 당시의 세대 수를 별도로 복원하지 않았다. 성동구의 “(1-10)”과 “굿모닝하이츠”는 세대 수를 확인할 수 없어 2014년 거래를 각각 1건 제외하였다. 같은 단지명이 두 구에 존재하므로 회귀의 군집은 자치구와 단지명을 결합하여 구분하였다. 공간자료의 연결에는 자치구와 출발지 ID를 함께 사용하였다.
단지 좌표는 실거래자료의 시군구와 번지를 이용해 지오코딩한 주소 기반 대표점이다. 공원 대표점은 전국도시공원정보표준데이터의 위도와 경도에 기초하였으며, 서울숲은 서울시 주요 공원현황의 주소를 이용해 목록에 추가하였다. 서울숲의 면적은 480,994m2이다. 단지 좌표를 실제 정문 또는 기하학적 중심점으로, 공원 대표점을 실제 출입구로 해석하지 않았다(표 2 참조).
*한강의 지도 표시용 점은 66개이나 거리행렬의 도착점은 64개이다. 도로망, 시설 위치 및 필지 도형은 최근 시점의 자료를 두 거래연도에 공통으로 적용하였다.
거리는 서울시 자치구별 도보 네트워크 공간정보(2024년 7월)를 도로망으로 하여 QGIS 3.42의 QNEAT3 O-D 행렬 기능(OD matrix from layers as lines, m:n)으로 산출하였다. 최적화 기준은 최단거리(shortest path, distance optimization)이고 도로망 링크는 양방향으로 두었으며, 출발점과 도착점에서 도로망까지의 진입비용과 진출비용은 타원체 기준 직선거리(ellipsoidal)로 계산하고 위상 허용오차(topology tolerance)는 기본값 0을 적용하였다. 거리값은 망 진입비용, 망 내부 경로비용 및 진출비용을 합한 총비용(m)이며 100m 단위로 환산하였다. 주요 점과 도로 레이어의 좌표계는 EPSG:5186이다. 한강과 중랑천의 도착점은 중심선을 따라 500m 간격으로 배치한 점이며, 이 지표는 실제 수변 출입시설이나 조망을 직접 측정하지 않는다. 자료 구축 과정에서 확인한 사항은 부록 3에 정리하였다.
공원 목록과 지도에는 1,768개 대표점이 있으며, 거리행렬의 계산 대상은 이 가운데 1,639개 공원이다. 최근접 공원거리는 단지별로 유효한 경로가 있는 공원까지의 거리 중 최솟값으로 정의하였다. 동대문구 401,555쌍 중 245쌍, 성동구 216,348쌍 중 133쌍은 경로가 산출되지 않았으나 모든 단지에 유효한 경로가 있었으며, 결측 경로를 0m로 치환하지 않았다. 행렬의 도착점은 GIS 공원 대표점의 식별자(fid)로 공원의 이름, 유형 및 면적에 연결하였고, 계산 대상 공원에는 모두 양수의 면적값이 있었다. 서울숲은 전국도시공원정보표준데이터에 포함되지 않아 서울시 주요 공원현황으로 목록에 추가하였으나, 1,639개 공원 거리행렬의 도착점에는 반영되지 않아 거리와 면적지수 산출에서 제외되었다.
면적 접근성 지수는 다음과 같이 정의하였다.
Vg는 단지 g에서 유효한 경로가 있는 공원의 집합이며, areaj는 공원면적(m2), dgj는 총비용(m)이다. 감쇠계수 γ는 1, 1.5, 2로 설정하였다. 면적은 공원 공급 규모를 나타내며 시설과 관리 상태 및 경관의 품질 전체를 대리하지 않는다. 서울숲의 미관측 경로는 임의의 거리로 보충하지 않았다.
지하철 지수는 250m × 250m 격자와 단지의 지적 필지 도형(기준일 2025년 12월 1일)이 교차하는 행에서 역, 환승 및 노선 관련 표시값을 합한 뒤 단지별로 집계한 무차원 점수이다. 산식은 이며 Rg는 단지 g의 교차행 집합이다. 표시값은 지하철역, 환승역, 노선(100m 간격 점)의 500m 버퍼와 필지 조각의 교차 여부에 따라 연도별로 부여한 값(교차 시 1)이며, 교차행은 동대문구 432개와 성동구 298개이다. 2014년 이후 신설된 역과 환승역의 버퍼는 두 구의 필지 조각과 교차하지 않았고 노선 버퍼의 연도 간 차이도 표시값을 바꾸지 않아, 두 연도의 지수는 377개 단지 모두 같았다. 이 지수는 격자당 평균이나 지하철역까지의 거리가 아니며, 합산 점수는 필지가 걸치는 격자 수에 따라 커지는 구조이므로 필지 규모와 무관하지 않다. 단지별 합계는 단지명을 기준으로 거래자료에 결합하였다.
가격모형의 종속변수는 원/m2 단위 거래가격의 자연로그이며 구별 두 연도 합산 분포의 1백분위와 99백분위에서 윈저화하였다. 하위표본에서도 같은 절단 경계와 중심화 기준을 유지하였다. 통제변수는 전용면적, 층, 건축연도, 세대 수, 지하철 접근 지수, 소매점 거리, 병원 거리 및 초등학교 거리였다(표 3 참조). 초등학교 거리는 실제 통학구역이나 학교 배정과 구분하였다.
가격모형(3.2–3.5절 및 부록 2)은 거래자료와 당시 구축한 공원 거리행렬을 결합하여 추정하였다. 이후 1,639개 공원을 대상으로 한 도보 네트워크 거리행렬로 377개 단지의 공간변수를 다시 산출하였으며, 3.1절의 기술통계는 이 값에 따른 것이다. 다시 산출한 공원거리와 한강거리의 상관은 동대문구 +0.404, 성동구 −0.356으로, 가격모형 추정에 사용한 공간변수의 값(+0.40, −0.36)과 일치하였다. 이에 따라 최근접 공원거리 변수는 두 자료 간에 일관되게 구축된 것으로 판단하였다. 다만 갱신된 행렬에는 서울숲이 도착점으로 포함되지 않았으므로, 서울숲 포함 여부를 비교한 면적지수 결과(표 4 참조)는 가격모형 추정 당시의 행렬에 기초한다.
*구별 전체 거래분포의 지표 표준편차를 사용하였다. 셀은 로그가격 연관, [단지 군집 95% 신뢰구간], p값이다. 서울숲 포함 여부는 가격모형 추정 당시의 행렬에서 비교한 것이다.
거래 주모형 M1은 로 설정하였다. y는 윈저화 로그가격, P, H, R은 100m 단위의 공원, 한강, 중랑천 거리, T는 2024년 더미, X는 표 3의 8개 통제변수이다. 위첨자 c는 구별 전체 거래평균 중심화를 뜻하며 하위표본에서도 같은 기준을 사용하였다. M2에는 세 거리와 T의 상호작용을, M3에는 M2와 함께 공원거리와 두 수변거리의 상호작용을 포함하였다. M2의 2024년 기울기는 주계수와 연도 교차항의 합으로 계산하였으며 공분산을 반영하였다. 통합 M3-C에서는 전체 평균으로 중심화한 M3에 성동구 더미와 세 거리의 성동구 교차항을 추가하고 나머지 기울기는 두 구에 공통으로 제한하였다.
주된 추론에는 동일 단지의 거래를 하나의 군집으로 묶는 CR1 표준오차와 t(G–1) 분포를 사용하였다(Moulton, 1990; Cameron and Miller, 2015). 군집 수 G는 동대문구 245개, 성동구 132개, 통합 377개였다. HC1 이분산 표준오차에 대한 정규근사 결과는 비교용으로 제시하였다. 군집 보정은 동일한 OLS 점추정의 불확실성을 바꾸는 반면, 동일가중은 목적함수에서 단지의 비중을 바꾼다. 이를 구분하여 단지와 연도의 조합별 가중치 합이 1인 wgt=1/ngt, 고유 단지별 가중치 합이 1인 wg=1/(ngt× 관측연도수), 단지별 연도별 로그가격과 원 설계행렬의 평균을 각 1행으로 둔 회귀를 비교하였다. 세대 수를 공변량으로 넣는 것만으로 거래량의 비중이 같아지는 것은 아니다.
공간모형에서는 자치구별 연도별 단지와 통합 연도별 단지의 6개 단면을 구성하여 동일한 평균 설계변수로 OLS, SAR(y = ρWy + Xβ + ε), SEM(y = Xβ + u, u = λWu + ε)을 비교하였다(Anselin, 1988). 단지 경위도를 EPSG:5179로 변환하고 평면거리의 최근접 이웃 k=5, 8, 10을 사용하였다. 자기이웃을 제외한 방향성 KNN을 행 표준화하였고 거리 동률은 자치구와 단지명 순서로 처리하였다. 통합 표본에서는 구 경계를 넘는 이웃을 허용하였다. SAR와 SEM은 최대우도 추정에 따른 모형기반 정규근사 신뢰구간을 사용하므로 거래모형의 군집 추론과 구분하였다. SAR의 직접효과와 총효과는 공간승수 (I–ρW)−1 및 계수 공분산을 이용한 델타법으로 산출하였다. 잔차 Moran 검정에는 999회 양측 순열을 사용하였고 SEM은 공간필터 후 혁신잔차를 대상으로 하였다.
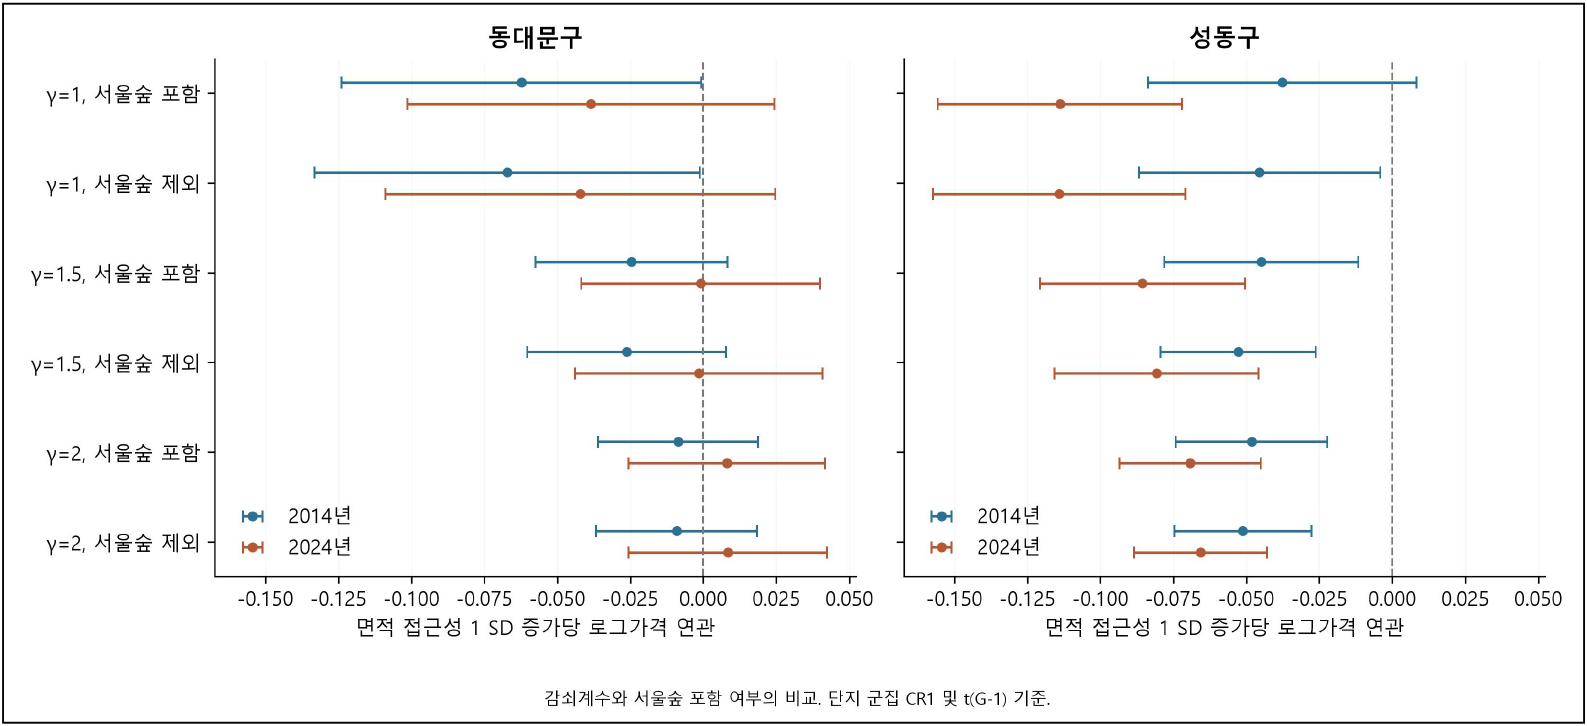
면적지수 모형 M4는 M1의 공원거리를 면적 접근성 Aγ로 교체하고 Aγ와 T의 상호작용을 추가하였다. 수변거리와 T의 상호작용은 포함하지 않았으며 구별 전체 거래분포의 지표 표준편차 1단위에 대한 연관을 보고하였다. 표 4의 감쇠계수와 서울숲 포함 여부 비교는 가격모형 추정 당시의 행렬에 기초하며, 1,639개 공원 행렬로 다시 산출한 지수의 정의와 기술통계는 2.2와 3.1에 제시하였다.
함수형은 M1 적합값의 제곱과 세제곱을 추가한 군집 공분산 RESET 검정으로 점검하였다(Ramsey, 1969). 공원거리와 한강거리는 중심화 제약의 자연 3차 스플라인(df = 4)으로 검토하였고 절점은 구별 전체 거래분포에서 고정하였다. 성동구에서 한강 중심선 거리 1,000m, 1,500m, 2,000m 이내의 단지를 각각 제외한 분석과 중랑천 관련 항을 제외한 분석을 병행하였다. 연도별 독립 추정, 두 시점 공통단지 표본, 윈저화하지 않은 가격, 연월 고정효과 및 통합모형의 구와 연도 교차항도 검토하였다. 법정동 고정효과는 주소로 확인되는 범위에서 부여하였다.
추정 안정성은 유의수준의 통과 여부만으로 판단하지 않고 부호, 크기, 95% 신뢰구간 및 추정대상의 변화를 함께 검토하였다. 군집 보정에 따른 p값의 변화를 점추정 부호의 변화로 기술하지 않았으며, 가중 방식과 공간모형의 비교에서는 표본과 오차 가정을 명시하였다. 본 연구는 사전등록한 확증 연구가 아니며 개별 p값은 다중비교 조정값이 아니다. 따라서 0.05를 넘나드는 것만으로 모형의 우열이나 인과적 기전을 판정하지 않았다(Lakens et al., 2018).
3. 분석 결과
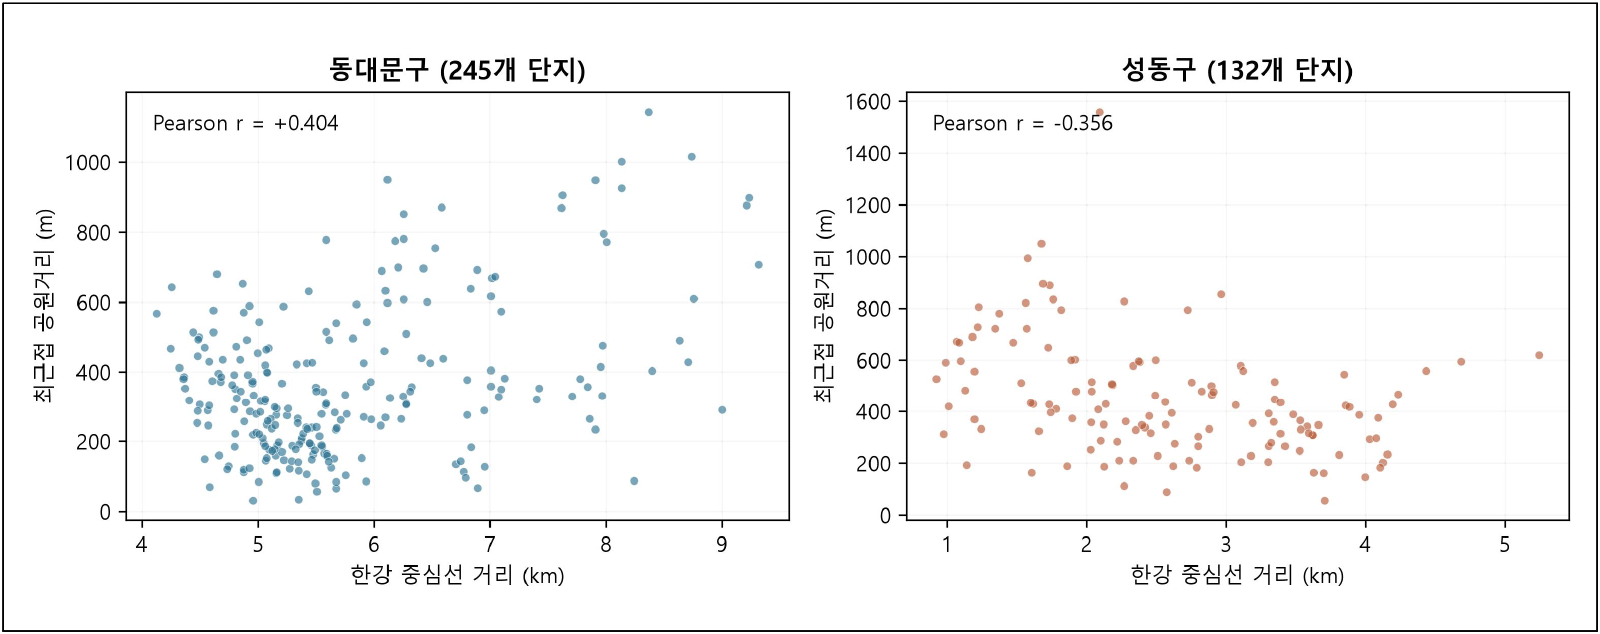
1,639개 공원 대상 거리행렬을 단지별 동일가중으로 집계한 평균 공원거리는 동대문구 361.77m, 성동구 442.06m이었다. 평균 한강거리는 각각 5,768.22m와 2,574.40m, 평균 중랑천거리는 1,738.44m와 1,921.60m였다. 공원거리와 한강거리의 Pearson 상관은 동대문구 +0.404, 성동구 −0.356으로 대조적인 방향을 보였다(표 5, 그림 2 참조). 이 상관은 두 지역의 공간적 배치를 설명하며 가격회귀계수의 원인을 확정하는 근거는 아니다. 서울숲(480,994m2)이 제외되었으므로 성동구의 공원거리 평균은 과대, 면적지수 평균은 과소 추정되었을 수 있으며, 이러한 편의는 서울숲 인근 단지에 집중된다. 서울숲이 한강에 인접해 있으므로, 성동구의 음의 상관(−0.356) 역시 실제보다 강하게 나타났을 가능성이 있다.
| 자치구 | 단지 수 | 공원거리 평균(m) | 한강거리 평균(m) | 중랑천거리 평균(m) | 공원과 한강 상관 |
|---|---|---|---|---|---|
| 동대문구 | 245 | 361.77 | 5,768.22 | 1,738.44 | +0.404 |
| 성동구 | 132 | 442.06 | 2,574.40 | 1,921.60 | −0.356 |
단지마다 동일한 비중을 부여하였다. 최근접 공원거리는 1,639개 공원 대상 행렬의 유효 경로 최솟값이다.
최근접 공원 유형은 동대문구에서 근린공원 23단지, 소공원 49단지, 어린이공원 173단지였으며 성동구에서는 각각 13단지, 40단지, 79단지였다. γ = 2인 면적 접근성 지수의 평균은 동대문구 6,251.52, 성동구 6,436.37이었다. γ = 1과 γ = 1.5 지수도 같은 입력으로 계산하였다. 이 값은 공급 면적을 거리로 감쇠한 공간지표이며 화폐 단위의 편익이나 가격계수가 아니다.
M1의 공원거리 100m당 계수는 동대문구 −0.003, 성동구 +0.014였으며 단지 군집 95% 신뢰구간은 각각 [−0.01517, +0.00736], [−0.00834, +0.03711]이었다(표 6 참조). HC1 정규근사의 p값은 두 구 모두 0.001보다 작았으나 단지 군집 추론의 p값은 각각 0.4956과 0.2128이었다. 이 비교에서는 점추정이 동일하고 단지 내 오차 의존을 반영한 불확실성이 달라졌다. 신뢰구간이 0을 포함한다는 사실만으로 연관이 정확히 0이거나 두 구가 동일하다고 판단하지 않았다.
*셀은 계수, [95% 신뢰구간], p값이다. 단지 군집 CR1과 t(G−1)을 사용하였다. 공원거리 HC1 표준오차는 각각 0.001085와 0.001557이었다. 표 4, 표 6–10의 가격계수는 가격모형 추정 당시의 거리행렬에 기초한다(2.2 참조).
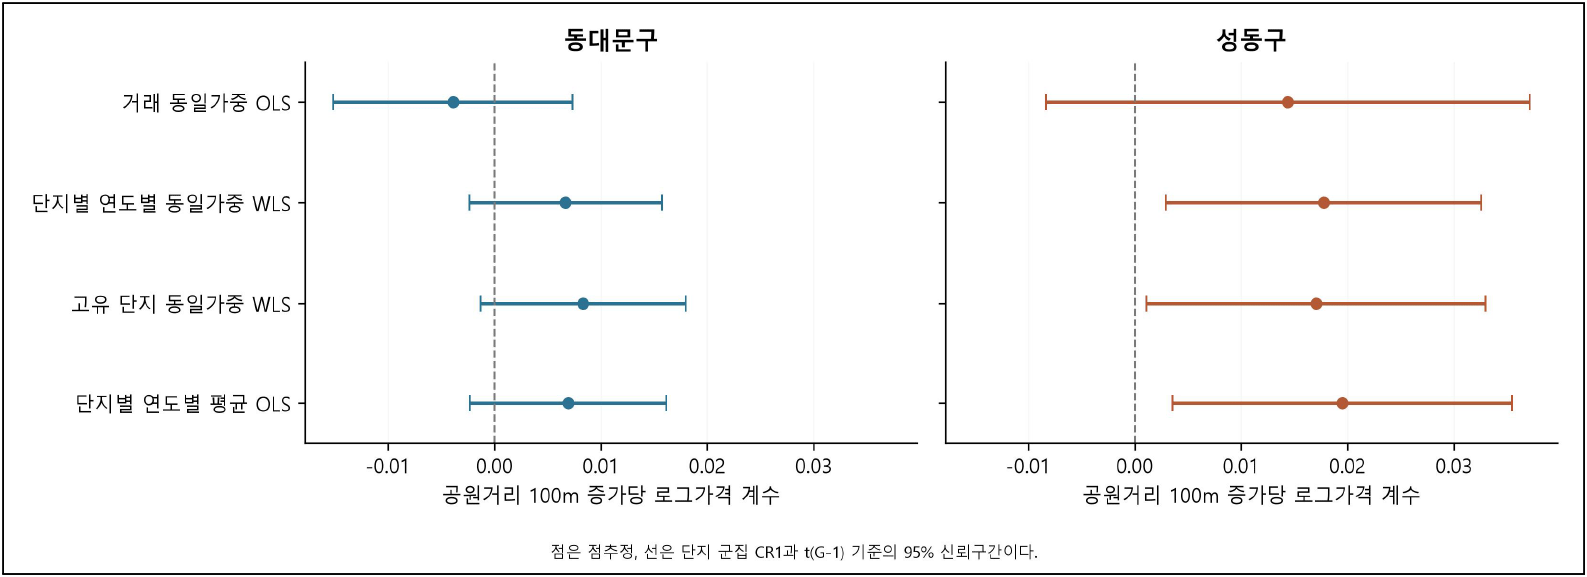
단지 비중을 달리한 분석에서는 동대문구의 공원거리 계수가 거래가중 −0.00390에서 단지와 연도의 조합별 동일가중 +0.00668, 고유 단지 동일가중 +0.00833, 평균 집계 +0.00692로 달라졌다. 모든 군집 신뢰구간에는 0이 포함되었다. 성동구는 같은 순서로 +0.01439, +0.01775, +0.01704, +0.01951이었으며 세 보조 추정의 군집 신뢰구간은 0을 포함하지 않았다(표 7, 그림 3 참조). 따라서 동일가중이 성동구의 양의 연관을 일률적으로 약화하였다고 해석하지 않았다.
*단지 및 연도 동일가중은 각 조합별 가중치 합을 1로, 고유 단지 동일가중은 두 연도 전체의 단지별 가중치 합을 1로 설정하였다. 집계행은 단지별 연도별 설계행렬과 로그가격의 평균이다.
구별 연도별 거래 상위 10% 단지가 전체 거래의 약 44.7–51.3%를 차지하였으며 세대 수와 거래 건수의 단지 수준 상관은 0.825–0.879였다. 한 단지씩 제외한 M1 계수의 범위는 동대문구 −0.00607~–0.00075, 성동구 +0.00494–+0.02412로 어느 한 단지의 제외만으로 부호가 달라지지는 않았다. 가중에 따른 차이는 특정 대단지 하나의 영향으로 단정하지 않고 여러 단지의 거래 구성과 추정대상의 차이로 해석하였다.
시점 상호작용의 상세 결과는 부록 1에 제시하였다. M2의 2024년과 2014년간 공원거리 기울기 차이는 동대문구 +0.02150, 성동구 +0.00825였다. 이는 다른 구조 및 입지 기울기를 공통으로 제한한 두 단면의 조건부 차이이며 장기 선호 변화나 정책 충격의 인과효과는 아니다.
같은 단지별 연도별 단면에 대한 OLS, SAR, SEM을 비교하였다(표 8 참조). 성동구 2014년의 공원거리 계수는 단지 OLS +0.02921, SAR +0.02656–+0.02840, SEM +0.02588–+0.02943으로 양의 연관이 유지되었다. 성동구 2024년은 세 모형 모두 양수였으나 95% 신뢰구간에 0이 포함되었다. 동대문구 2024년의 일부 p값은 0.05 전후로 달라졌으나 이를 큰 부호 변화로 해석하지 않았다. 거래 M1과 단지 공간모형의 차이에는 집계, 가중, 연도별 표본 및 모형 변경이 함께 포함되므로 그 차이를 모두 공간 보정의 영향으로 돌리지 않았다.
*셀은 공원거리 100m당 계수, [95% 신뢰구간], p값이다. OLS는 HC1 정규근사이고 SAR 및 SEM은 최대우도 모형기반 정규근사이다. 동일한 11개 설명변수를 사용하였다. SAR 구조계수는 총효과와 다르다.
성동구 2014년 k = 5에서 SAR 직접효과는 +0.02849(95% 신뢰구간 [0.01008, 0.04690]), 총효과는 +0.03309 ([0.01063, 0.05556])였다. 통합 단지 OLS 잔차에는 두 연도와 모든 k에서 양의 공간상관이 관찰되었고 순열 p값은 0.001이었다. 같은 통합 단면에서 SAR 잔차와 SEM 혁신잔차 진단의 p값은 모두 0.18보다 컸다. 이는 명시한 공간가중행렬 아래에서 잔차 의존이 완화되었음을 나타내지만 인과적 식별이나 교란 제거를 입증하지는 않는다.
면적 접근성 모형에서는 성동구 계수가 γ = 1, 1.5, 2와 서울숲 포함 여부에 따른 여섯 사양에서 두 연도 모두 음수였다(표 4, 그림 4 참조). γ = 2인 경우 지수의 표준편차 1단위 증가에 대한 연관은 성동구 2014년 −0.04815, 2024년 −0.06925였다. 거리 증가는 접근성 악화를, 면적지수 증가는 접근성 개선을 뜻하므로 양의 거리계수와 음의 면적지수 계수는 접근성 방향을 맞추면 같은 방향이다. 다만 이 표의 지수는 2.2절에서 다시 산출한 1,639개 공원 지수와 입력 범위가 다르므로, 다시 산출한 지수의 가격 연관을 검증한 결과로 해석하지 않았다.
성동구에서 한강 중심선 거리 1,000m, 1,500m, 2,000m 이내의 단지를 각각 3개, 18개, 40개 제외하였을 때 M1 공원거리 계수는 +0.01425, +0.00462, +0.01194였다(표 9 참조). 1,500m 기준에서 감소가 컸으나 제외 범위에 따라 단조롭게 감소하지 않았고 부호도 역전되지 않았다. 한강 스플라인을 사용한 계수는 +0.00972였으며 모든 군집 신뢰구간에 0이 포함되었다. 따라서 수변 입지가 양의 공원거리 계수의 원인임을 직접 확인한 것으로 해석하지 않았다.
*제외 기준은 한강 중심선 거리로 실제 수변 경계에서의 거리와 다르다. 자연 3차 스플라인의 자유도는 4이며 전체 표본을 사용하였다.
RESET 검정은 동대문구 F(2,244) = 1.8942(p = 0.1527), 성동구 F(2,131) = 8.9782(p < 0.001)였다. 성동구에서는 지정 오류 가능성이 남으므로 로그 함수형의 적절성이 입증된 것으로 판단하지 않았다. 공원거리 스플라인의 추가 비선형 성분 검정 p값은 각각 0.8015와 0.0633이었다. 유연한 사양에서 관찰된 거리 기울기 역시 특정 함수형에 조건부로 해석하였다.
연월 고정효과의 M1 공원거리 계수는 동대문구 −0.00392(p = 0.4917), 성동구 +0.01436(p = 0.2130)였다. 법정동 고정효과를 포함한 동대문구 계수는 −0.00608(p = 0.3621)이었다. 성동구는 법정동을 확인하지 못한 1개 단지 37건을 제외한 동일한 4,920건에서 기준계수 +0.01380과 법정동 통제계수 +0.02383(p = 0.0011)을 비교하였다. 초등학교 거리와 법정동 범주는 실제 학군을 대신하지 않으므로 이 결과를 학군 교란이 해결되었다는 근거로 해석하지 않았다.
중랑천 관련 주효과와 상호작용을 제외한 구별 M1 공원거리 계수는 동대문구 −0.00302(p = 0.6036), 성동구 +0.01445(p = 0.2197)로 기존 방향이 유지되었다. 연도별 독립 추정과 두 시점 공통단지 분석 및 윈저화하지 않은 가격의 분석도 함께 검토하였다. 두 시점에 공통으로 관측된 단지는 동대문구 138개, 성동구 93개였으며 동일 주택의 반복매매 패널은 아니었다.
통합 M3-C의 공원거리와 성동구 교차항은 −0.07198(95% 신뢰구간 [−0.14521, +0.00126], p = 0.0541)이었다. 중랑천 관련 항을 제외하면 −0.01339(p = 0.6628)로 축소되었다(표 10 참조). 세 거리 교차항의 결합검정은 F(3,376) = 10.8689(p < 0.001), 두 수변 교차항의 결합검정은 F(2,376) = 14.7960(p < 0.001)이었다. 이는 공통 기울기 제약과 거리 간 상호작용의 평가점을 포함한 조건부 비교로, 구별 M1 계수의 단순 차이와 다르다. 모든 변수를 구별로 상호작용한 모형은 개별 구 모형과 같은 예측을 산출하였다. 따라서 큰 교차항을 중심화 자체의 결과나 두 구의 공원 선호 격차로 해석하지 않았다.
*모든 사양은 10,201건과 377개 군집을 사용하였다. 기준 M3-C는 나머지 기울기를 두 구에 공통으로 제한하였다.
4. 논의 및 결론
본 연구의 주된 결과는 다음과 같다. 성동구에서 최근접 공원거리와 가격의 양의 연관은 단지 동일가중, 법정동 고정효과, 2014년 단지 단면 공간모형 및 한강 인접 단지 제외 등 여러 사양에서 유지되었으며, 동대문구의 연관은 거래량 가중 방식에 따라 점추정의 부호가 달라질 만큼 민감하였다.
본 연구에서는 두 자치구의 최근접 공원거리와 가격의 연관을 추론 단위, 가중 방식, 공간 의존 및 접근성 정의에 따라 검토하였다. 최근접 지표의 한계에 관한 선행 논의에 더하여 같은 점추정의 불확실성 변화와 추정대상의 변화를 구분하고, 사양에 민감한 결과와 여러 비교에서 유지되는 결과를 함께 제시하였다. 여기서 추정 안정성은 사용한 자료와 사양 범위 안의 성질이며 공원 편익 측정의 타당성이나 인과성을 보장하지 않는다.
첫째, 군집 보정 후 주모형의 신뢰구간이 0을 포함하였으나 모든 보조 분석에서 연관이 사라진 것은 아니었다. 성동구의 양의 거리 연관은 동일가중, 법정동 고정효과 및 2014년 단지 단면 공간모형에서도 관찰되었다. 동대문구에서는 거래량 비중을 바꾸었을 때 점추정의 부호가 달라졌다. 집합 수준 변수를 포함한 미시자료의 추론에서 단지 내 오차 의존을 고려해야 한다는 논의(Moulton, 1990; Cameron and Miller, 2015)는 불확실성과 점추정의 차이를 구분하는 근거가 되었다.
둘째, 성동구의 양의 공원거리 계수를 수변 입지의 인과적 영향이나 공원에 대한 비선호로 확정하지 않았다. 한강 인접 단지 제외 및 비선형 통제로도 음의 거리 기울기가 복원되지 않았고, 면적지수의 음의 계수는 접근성 방향을 맞추면 양의 거리계수와 같은 방향이었다. 공원의 유형과 규모에 따라 가격 연관이 달라진다는 연구(Czembrowski and Kronenberg, 2016; Kim et al., 2019; 김혜림과 홍성조, 2021), 서울숲과 한강 입지를 다룬 국내 연구(신상영 등, 2006; 배상영 등, 2018)는 가능한 설명을 제공하지만 본 사례에서 그 기전을 직접 검증한 근거는 아니다.
셋째, 통합모형의 공원거리와 자치구 교차항은 구별 주모형 계수의 단순 차이가 아니었다. 나머지 기울기의 공통 제약과 상호작용의 평가점이 포함된 조건부 비교였으며, 중랑천 항 제외 후 교차항의 크기가 크게 축소되었다. 이에 단일 교차항의 부호로 두 구의 선호 차이를 설명하기보다 공동 입지 분포와 모형 제약을 함께 검토하였다.
이상의 점검 항목은 두 사례에서 귀납적으로 구성한 것이며, 다른 지역의 안정성을 예측하는 보편적인 임계값은 제시하지 않았다. 공원과 수변거리의 상관 구조, 공동 지지영역, 거래 집중도, 단지 내 오차 의존, 잔차 공간상관 및 함수형을 각각 확인할 수 있다. 여러 사양에서 계수 크기와 신뢰구간이 비슷하면 해당 범위의 추정 안정성을 논의할 수 있으나, 실제 학군과 공원 품질 및 출입구가 누락되거나 공동 입지 분포가 희소한 경우 이 점검만으로 정책 가치를 확정하기 어렵다.
조경 및 도시계획 실무에서는 조건부 헤도닉 계수의 적용 범위를 문서화할 필요가 있다. 공원 조성의 비용과 편익을 검토할 때에는 거리계수를 전체 사업 편익으로 환산하기에 앞서 추정대상, 신뢰구간 및 평가 대상 지역의 공원 유형을 확인할 수 있다. 민간공원 특례사업의 대안 비교에서는 수변 입지와 주거개발 구성을 함께 검토하고, 공원녹지 기본계획에서는 실제 출입구와 보행권 및 이용과 형평성 자료를 함께 고려할 수 있다. 이는 해당 제도에서 특정 산식이 사용된다는 사실 주장이나 본 계수로 총편익을 산정할 수 있다는 주장이 아니라 해석 범위를 점검하는 적용 예시이다.
두 시점의 비교에는 거시 시장과 지역 변화의 제약이 남았다. 연도 및 연월 고정효과가 공통 가격 수준의 차이를 흡수하더라도 금리, 대출규제, 코로나19 전후 변화 및 지역별 정책 충격의 개별 기여를 분리하지는 못하였다. 초등학교 거리와 법정동도 실제 학교 배정이나 교육 수요를 충분히 대리하지 않았다. 정비사업 제외 표본은 단지별 제외 목록에 조건부이며, 모든 단지가 거래 당시 같은 단계였다는 가정은 하지 않았다.
공간자료의 측정 범위도 해석을 제한하였다. 최근 시점의 도로망과 시설 정보를 두 거래연도에 공통 적용한 값은 과거 상태를 각각 복원하지 않았으며, 수계 중심선의 표본점까지의 비용은 실제 출입구 접근성이나 조망과 다르다. 공원 목록 1,768개와 거리행렬 대상 1,639개는 서로 다른 범위이며, 서울숲은 다시 산출한 거리와 면적지수에 반영되지 않았다. 다시 산출한 공간변수와 가격모형의 입력 범위에 차이가 있으므로, 재구축한 지표의 가격 연관은 별도의 추정 없이 확정하지 않았다.
최근접 공원거리와 아파트 가격의 연관에는 사양에 따라 달라지는 부분과 유지되는 부분이 함께 존재하였다. 두 사례의 결과는 거래 단위의 유의성을 단지 수준의 독립적인 증거로 읽지 않고, 가중 방식과 공간모형이 비교하는 대상을 구분하며, 접근성 지표의 방향과 자료 범위를 명시할 필요를 보여 주었다. 이러한 결과는 공원 편익을 부정하는 근거가 아니라 특정 지역과 자료 및 모형의 조건부 연관을 정책적 가치로 확대할 때 필요한 검토 범위를 제시하였다.


