 PDF Download
 PubReader
 Export Citation
 Email the Author
 Share Facebook
 Share Twitter
 Cited by 0 Article
 Metrics (View:35)

1. 서론
한국의 국가정원은 2015년 「수목원·정원의 조성 및 진흥에 관한 법률」 개정 이후 새로운 유형의 공공 녹지공간으로 부상하였다. 현재 순천만국가정원과 태화강국가정원 두 곳이 지정·운영되고 있으나, 순천만은 2013년 국제정원박람회를 위해 계획적으로 조성된 정원인 반면, 태화강은 기존 도시공원을 국가정원으로 전환하였다는 차이가 있다(이상현 등, 2020). 또한 두 공간이 동일한 ‘국가정원’ 지위를 부여받았으나 조성 배경의 차이와 마찬가지로 이용 현황에서도 격차가 뚜렷하다. 2022년 기준 순천만국가정원 방문자는 1,678,655명인 데 비해 태화강국가정원은 968,726명으로 약 60% 수준에 머물렀다(이지선과 서주환, 2024). 이는 단순한 양적 차이를 넘어, 두 국가정원의 방문에 영향을 미치는 요소, 특히 방문자가 체감하는 경관의 차이를 분석할 필요성을 제기한다.
경관은 방문 만족과 재방문 의도를 결정하는 주요 요인으로 보고되어 왔다. Peng et al.(2025)은 중국 역사문화 관광지 방문객을 대상으로 심미적 동기가 방문 만족과 재방문 의도에 유의한 정(+)의 영향을 미침을 보고하였고, Chen and Chen(2026)은 정원 방문객이 지각하는 가치가 만족을 매개로 재방문 의향에 영향을 미침을 확인하였다. 국내 선행연구에서도 태화강은 주제정원 다양성과 식생 계절성이 순천만보다 낮게 평가되었고, 계절 의존적 정원의 경관 연속성 확보가 과제로 지적되었다(송즈쉬앤과 이혁재, 2023; 최정원 등, 2023; 권진욱과 최동아, 2024). 그러나 이들 연구는 설문과 현장 관찰에 기초하여 다수 방문자가 실제로 인식한 경관을 개별 이미지 수준에서 포착하지 못하였으며, 국가정원의 경관 관리 전략을 방문자의 경관 인식에 근거하여 수립하기 위한 실증 자료는 여전히 부족하다.
방문자가 촬영하여 지도와 소셜미디어에 공유하는 이미지는 경관에 대한 집단적 인식을 담은 자료로 빠르게 축적되고 있으나(Havinga et al., 2021; Huai et al., 2022), 수천에서 수만 장에 이르는 이미지를 사람이 직접 판독하고 코딩하는 데는 한계가 있어 딥러닝을 이용한 자동 분석이 경관 연구의 주요 흐름으로 자리 잡았다(김유진과 강영은, 2021). 다만 기존의 자동 분석은 대부분 사전에 정의된 범주로 이미지를 분류하는 방식이어서, 방문자가 인식한 경관을 정해진 범주 내에서만 파악할 수 있다는 한계가 있다.
이러한 한계를 보완할 수 있는 도구로 최근 이미지와 언어를 함께 학습한 Vision-Language 모델이 주목받고 있다. BLIP-2(bootstrapping language-image pre-training 2)는 이미지의 내용을 자연어로 설명하는 캡셔닝 기능을 제공하여, 사전에 정의된 범주 없이 이미지의 내용을 맥락과 함께 서술할 수 있다(Li et al., 2023). CLIP (contrastive language-image pre-training)은 이미지의 시각적 특성을 고차원 벡터로 임베딩하여 장면 간 유사성을 정량화한다(Radford et al., 2021). 그러나 이러한 멀티모달(Multi-modal) AI 기술이 한국의 국가정원 연구에 통합적으로 적용된 사례는 찾아보기 어렵다.
따라서 본 연구는 BLIP-2를 활용하여 방문자가 체감한 국가정원의 경관을 의미론적(semantic)으로 분석하고, 동시에 CLIP 임베딩을 통해 시각적 특성의 차이를 구조적으로 군집화하고자 한다. 구체적으로는 첫째, 두 국가정원에서 방문자가 촬영한 경관 요소는 어떻게 다르며 그 차이는 키워드의 양에서 비롯되는가 아니면 구성에서 비롯되는가, 둘째, 그러한 차이는 계절에 따라 어떻게 변동하는가, 셋째, BLIP-2가 포착한 의미론적 차이와 CLIP이 포착한 시각적 구조는 서로 일관된 양상을 보이는가를 규명하는 데 목적을 둔다. 이와 같이 경관 요소와 시각적 구조를 함께 분석하면 국가정원의 경관 특성 차이를 다각적으로 규명할 수 있으며, 그 결과는 국가와 지자체가 국가정원을 경관 자산으로 관리하고 홍보하는 전략에 활용될 수 있을 것이다.
2. 이론적 배경 및 관련 연구
국가정원은 「수목원·정원의 조성 및 진흥에 관한 법률」에 따라 국가가 조성·운영·관리하는 정원으로, 지방정원 중 면적 30만 m2 이상, 전문관리인력 20명 이상 등의 조건을 갖춘 곳을 지정한다(수목원정원법 시행령, 2023). 현재 두 곳이 지정되어 있으나, 두 국가정원의 조성배경은 서로 다르다.
순천만국가정원은 2013년 순천만국제정원박람회를 위해 체계적으로 계획·조성된 박람회장을 박람회 이후 정원으로 존치한 것으로, 2015년 제1호 국가정원으로 지정되었다(김준선, 2016). 2023년 박람회에서 980만 명 방문, 생산유발효과 1조 5,900억 원의 성과를 창출하였다(조홍복, 2024). 김태원과 김건우(2023)는 2013년과 2023년 두 차례 순천만국제정원박람회의 개최 효과를 방문객 인식을 중심으로 비교하여, 두 박람회 모두 만족도가 높게 나타났으며 특히 경제 및 환경·생태 측면의 인식이 만족도에 공통적으로 영향을 미쳤음을 확인하였다. 반면 태화강국가정원은 ‘죽음의 강’으로 불리던 태화강을 2004년 에코폴리스 울산 선언 이후 10년간 생태복원으로 되살리고, 그 둔치에 조성된 도시공원으로, 2019년 제2호 국가정원으로 전환되었다(이상현, 2013; 이상현 등, 2020).
한편 2024년 9월 국제원예생산자협회(AIPH) 제76차 총회에서 2028 국제정원박람회의 태화강국가정원 개최가 승인되었다(박석철, 2024). 울산연구원은 박람회와 연계한 태화강변 경관사업의 추진방안을 검토하고 있으며(신한나, 2026), 이에 따라 태화강국가정원의 경관 특성과 경관 관리 전략에 대한 검토가 요구되는 상황이다.
국가정원의 경관 평가는 주로 전문가 평가나 방문객 설문을 통해 이루어져 왔다. 이정(2017)은 방문객 설문으로 순천만국가정원의 매력속성을, 권진욱과 최동아(2024)는 전문가와 시민 설문으로 두 국가정원의 정원문화지수를 평가하였고, 송즈쉬앤과 이혁재(2023)는 경관 사진의 형용사 척도 평가로, 최정원 등(2023)은 이용객 관찰로 태화강국가정원의 계절에 따른 경관 변화와 이용 행태를 분석하였다. 다만 이들 연구는 특정 시점에 소수의 전문가나 응답자가 평가한 결과이거나 제한된 기간의 관찰에 기초하므로, 다년간 축적된 다수 방문자의 경관 인식을 포착하기에는 어려움이 있다.
이러한 배경에서 소셜미디어 이미지와 AI를 결합한 경관 분석이 확대되어 왔다. 김유진과 강영은(2021)은 딥러닝 기반 경관 평가의 적용 가능성을 검토하며 합성곱신경망(CNN) 기반 이미지 분류·분할 기법이 경관 평가에 활용될 수 있음을 제시하였다. 실제 적용 연구는 초기에 CNN 기반 분류에 집중되어 이용자 활동사진의 자동 분류(이주경과 손용훈, 2022), 전시정원의 시각적 유사성 정량화(조우윤과 권진욱, 2024), 경관 형용사 분류(성정한과 이경진, 2023) 등이 시도되었다. 그러나 이들은 사전에 정의된 범주로 형태를 식별하는 데 국한되어 이미지의 맥락적 의미까지 읽어내지는 못하였다. 한편 범주를 미리 정하지 않고 이미지 자체의 유사성으로 유형을 도출하려는 시도도 있었다. Huai et al.(2022)은 장면 인식 결과를 군집화하여 경관 주제를 도출하였고, Kim and Kang(2022)은 관광지 사진의 CNN 특징 벡터를 t-SNE와 HDBSCAN으로 군집화하여 관광지별 이미지 범주를 귀납적으로 추출하였다. 그러나 두 연구 모두 장면 분류용 CNN 특징에 기반하므로 군집이 무엇을 뜻하는지는 연구자가 사진을 보고 판단해야 했고, 이미지에 대한 언어적 서술과 결합되지는 못하였다.
국외에서도 방문자가 촬영·공유한 이미지를 경관 평가 자료로 활용하는 연구가 축적되어(Havinga et al., 2021; Huai et al., 2022; Qi et al., 2023), 이용자가 자발적으로 촬영한 이미지가 경관에 대한 집단적 인식과 선호를 반영하는 자료로 기능할 수 있음이 확인되었으며, 국내에서도 황해권 등(2025)이 구글맵 리뷰의 텍스트와 이미지를 결합하여 한강공원의 이용자 인식과 공간 매력도를 분석한 바 있다. 최근에는 생성형 AI와 대규모 언어모델을 활용한 평가로 확장되고 있으나(Liu et al., 2025; Malekzadeh et al., 2025; Song et al., 2026), AI의 판단이 인간의 평가와 상당 부분 정합하면서도 정서적·심미적 차원에서는 차이가 보고되어, AI 기반 경관 평가는 전통적 평가를 대체하기보다 보완하는 도구로 논의되고 있다.
이미지와 텍스트를 함께 다루려는 시도도 이어졌다. 이다연 등(2023)은 VQA 기술로 이미지에서 행동, 연령 등 세부 정보를 추출했으나 계절 변화를 고려하지 못하였다. 국가정원을 대상으로는 박재영 등(2022)이 태화강국가정원의 인스타그램·블로그 게시물을 수집하여 계절별 게시 비중과 해시태그 분포를 분석한 바 있다. 한편 텍스트 기반 연구들(남윤섭과 고성일, 2024; 강하나 등, 2025)은 온라인 리뷰 분석으로 방문자의 주관적 경험을 포착하는 데 의의를 찾았으나, 이를 시각적 경관 요소로 비교하는 데에는 제한적이었다.
최근 등장한 BLIP-2는 이러한 한계를 극복할 수 있는 Vision-Language 모델이다. 약 1.29억 개의 이미지로 사전학습되어, 새로운 자료에 대한 추가 학습 없이 사전학습된 상태 그대로 적용하는 제로샷(zero-shot) 방식으로 이미지의 시각적 요소와 의미를 동시에 서술할 수 있다(Li et al., 2023). 한편 CLIP은 텍스트와 이미지를 같은 벡터 공간에 대응시키므로, 텍스트로 적은 개념과 이미지 사이의 유사도를 계산하여 경관 선호도나 심미적 품질을 평가하는 데 활용되고 있다(Levering et al., 2024; 이청훈과 심지수, 2026; Kang et al., 2026). 그러나 이들 연구는 연구자가 미리 정한 개념을 기준으로 이미지를 평가하므로, 방문자가 인식한 경관 요소를 사전 정의 없이 언어로 추출하는 데는 한계가 있다.
이상의 선행 연구를 정리하면 표 1과 같다. 선행 연구 대부분이 특정 시점의 평가나 사전에 정의된 범주에 의존한 것과 달리, 본 연구는 방문자가 직접 촬영·공유한 다년도의 이미지를 계절별로 분석한다. 이를 위해 방문자 촬영 이미지를 자연어로 서술하는 BLIP-2와 이미지 전체의 시각적 특성을 고차원 벡터 공간에서 군집화하는 CLIP을 결합하였다. 이를 통해 각 국가정원 경관을 개별 구성 요소와 군집 수준에서 특성을 비교하고자 한다.
| 구분 | 연구자 | 분석 대상 | 방법론 | 주요 결과 |
|---|---|---|---|---|
| 전통적 평가 | 이정(2017) | 순천만국가정원, 방문객 설문 617부 | 중요도-만족도(ISA) 분석과 요인분석 | |
| 최정원 등(2023) | 태화강국가정원(태화․삼호지구), 이용객 관찰 및 2차 자료 (설문 520명, 무인계수기 집계) | 전문 조사자 3명의 시설물 현황조사와 이용객 관찰․추적 | ||
| 송즈쉬앤과 이혁재(2023) | 태화강 15개 정원, 경관사진 15장 및 설문 58명 | 레퍼토리 그리드 기법으로 형용사 척도를 도출한 뒤 요인분석 | ||
| 권진욱과 최동아(2024) | 순천만․태화강국가정원, 전문가 및 시민 설문 72명 | 정원문화지수(델파이와 AHP로 확정한 27개 지표, 100점 만점) 평가 | ||
| AI 기반 분석 | 이주경과 손용훈(2022) | 국내 도시공원, 네이버 사진 40,560장 | CNN 전이학습(Xception) 이미지 분류 | |
| 이다연 등(2023) | 서울 도시공원 3개소, 인스타그램 사진 공원별 1,000장 | VQA 딥러닝 이미지 질의응답 | ||
| 성정한과 이경진(2023) | 포털 검색 ’힐링’ 이미지 15,097장 | VGG 16 전이학습 이미지 분류 | ||
| 조우윤과 권진욱(2024) | 국내외 전시정원 평면 이미지 322점 | VGG-16과 ResNet50 기반 DRG 모형 | ||
| 황해권 등(2025) | 서울 한강공원 4개소, 구글맵 리뷰 (공원별 4,290~17,207건) | TF-IDF․중심성 분석과 Vision API 라벨링․군집분석 | ||
| Havinga et al.(2021) | 영국, ScenicOrNot 경관사진 21만 7천 장과 Flickr 사진 | 딥러닝 심미성 예측 모형과 환경지표 모형 비교 | ||
| Huai et al.(2022) | 브뤼셀 도시공원 79개소, Flickr 사진 12,568장(실외 4,996장 분석) | 장면 인식, 이미지 군집화, 라벨링 | ||
| Kim and Kang(2022) | 서울 경복궁․인사동, 트립어드바이저 외국인 리뷰 사진 8,188장․3,695장 | VGG16(Places365) 512차원 특징의 t-SNE 축소와 HDBSCAN 군집화, 샴 네트워크로 노이즈 제거․분류 | ||
| Qi et al.(2023) | 중국 샤먼섬 24개 촬영지, 웨이보 사진 92,942장 | DeepLabV3+ 의미론적 분할과 요인분석․구조방정식 | ||
| Levering et al.(2024) | 영국, ScenicOrNot 경관사진 21만 2천 장 | CLIP 제로샷 프롬프트와 소수표본 선형 프로브 | ||
| Malekzadeh et al.(2025) | 헬싱키(핀란드), 구글 스트리트뷰 1,800여 장, 평가 참여자 24명 | GPT-4 프롬프트 평가와 의미론적 분할 | ||
| Liu et al.(2025) | 중국 5개 경관유형 대표사진 5장, 1,333명의 설문 응답 | 인구통계 속성을 부여한 GPT-4 에이전트와 인간 응답 비교 | ||
| Kang et al.(2026) | 선행연구 16편 취합, 도시녹지 이미지 159장 | SegFormer 의미론적 분할, CLIP 제로샷 추론, 랜덤 포레스트와 SHAP |
3. 연구방법
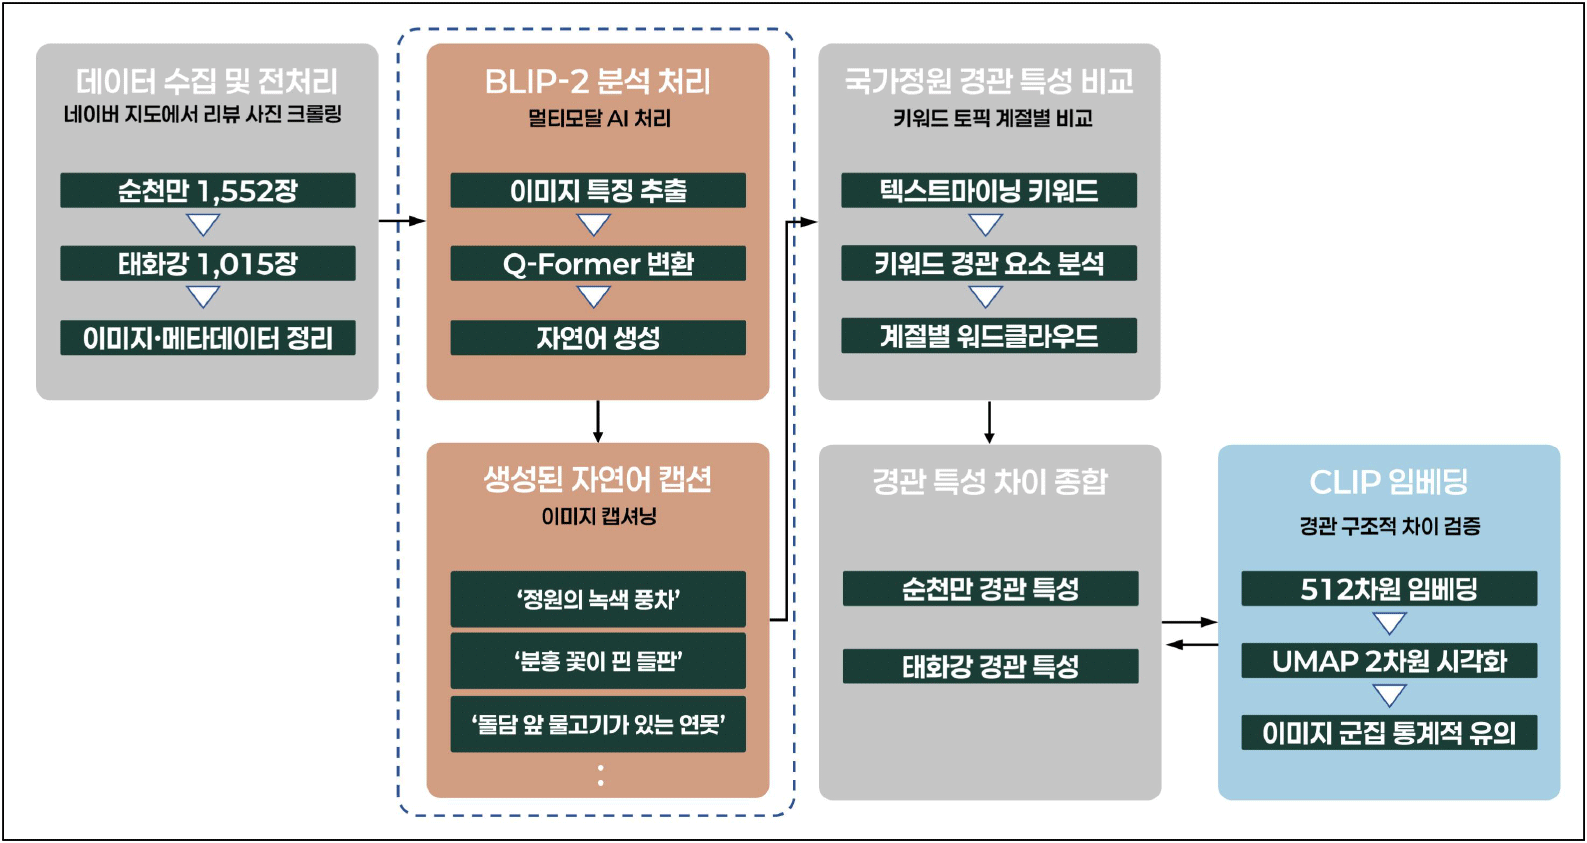
본 연구의 전체적인 틀은 크게 데이터 수집 및 전처리, BLIP-2 분석 처리, 국가정원 경관 특성 비교, CLIP으로 경관 특성 구조화 및 BLIP-2 분석 결과 검증의 4단계로 구성된다(그림 1 참조).
본 연구의 대상지는 현재 운영 중인 두 국가정원이다. 순천만국가정원은 전라남도 순천시에 약 92.7만 m2 규모로 2015년 지정되었고(순천시, 2024), 태화강국가정원은 울산광역시에 위치하며 약 83.5만 m2 규모로 2019년 지정되었다(울산광역시, 2024). 순천만국가정원은 하천을 사이에 두고 동·서 두 구역으로 나뉘며 서쪽에는 순천만국제습지센터와 수목원 구역(나무도감원, 한국정원, 에코지오온실 등), 동쪽에는 세계정원 13개소와 호수정원, 테마정원 16개소, 참여정원 32개소가 배치되어 있고 인접한 순천만습지도 관람이 가능하다. 태화강국가정원은 태화강 양안의 하천 부지에 조성된 태화지구(48.5만 m2)와 삼호지구(35.0만 m2)로 구성되며, 약 4km에 걸친 십리대숲을 축으로 6개 주제(생태·대나무·계절·수생·참여·무궁화)의 테마정원 20여 개소가 선형으로 배치되어 있다. 즉 순천만은 습지 배후의 평지에 기획된 박람회장형 정원, 태화강은 하천 둔치의 선형 공원형 정원이라는 공간 구조의 차이가 있다. 운영 방식에서도 차이가 있는데, 순천만국가정원은 성인 10,000원의 유료 입장(순천시민 2,000원)으로 운영되는 반면, 태화강국가정원은 하천 부지에 조성되어 24시간 무료로 개방된다. 이러한 조성 배경, 공간 구조, 운영 방식의 차이는 방문 목적과 촬영·공유 행태에 영향을 줄 수 있으므로 결과 해석 시 고려하였다.
분석 자료는 방문자가 네이버지도 리뷰에 직접 업로드한 이미지로, 이미지와 메타데이터는 Python 기반 웹 크롤링으로 수집하였다. 수집 과정에서 리뷰에 기록된 방문 날짜와 이미지 파일을 함께 저장하여 시계열 분석이 가능하도록 하였으며, 파일명을 기준으로 중복 여부를 확인한 결과 중복 이미지는 발견되지 않았다. 계절별 분류는 이 방문 날짜를 기준으로 봄은 3월부터 5월, 여름은 6월부터 8월, 가을은 9월부터 11월, 겨울은 12월부터 2월로 구분하였다. 한편 본 연구는 공개된 리뷰 이미지와 메타데이터만을 수집·활용하였으며, 작성자 계정 정보 등 개인 식별 정보는 수집 단계에서 제외하고 학술 목적으로만 분석하였다.
순천만은 2024년 6월부터 2025년 5월까지 1년간 수집한 907개 리뷰 가운데 이미지가 첨부된 578개 리뷰에서 1,552장을 분석에 사용하였다. 태화강은 동일 기간 데이터가 충분하지 않아 2020년 10월부터 2025년 5월까지 확대 수집하였으며, 498개 리뷰 가운데 이미지가 첨부된 258개 리뷰에서 1,015장을 분석에 사용하였다. 수집 기간이 다르므로 두 정원의 비교는 방문자 업로드 이미지에 누적된 경관 특성에 대한 탐색적(exploratory) 비교로 설정하였다. 기간 확대가 결과에 미치는 영향은 다음과 같이 점검하였다. 태화강 자료 가운데 순천만과 같은 기간(2024년 6월–2025년 5월)의 이미지 405장(리뷰 99개)만을 동일 기간 부분집합으로 추출하여 키워드 분석과 군집 분석을 같은 절차로 다시 수행하고, 전체 기간의 결과와 비교하였다.
사전학습된 BLIP-2모델을 활용하여 각 이미지에 대한 자연어 설명을 자동 생성하였다(Li et al., 2023). BLIP-2는 기존의 사전학습된 이미지 인식기(frozen image encoder)와 대규모 언어 모델(frozen LLM) 사이에 ‘Q-Former (querying transformer)’라는 경량 연결 모듈만을 새로 학습시켜, 두 모달리티를 효율적으로 연결하는 구조를 가진다(그림 2 참조). 이러한 설계로 인해 추가 학습 없이 제로샷 이미지 캡셔닝이 가능하며, COCO 캡셔닝 벤치마크에서 BLIP-2 계열 최상위 구성 기준 CIDEr 점수 145.8을 달성하여 우수한 성능을 입증하였다. 특히 한국의 정원과 같은 특수한 문화적 맥락에 대한 별도 파인튜닝 없이도 경관 요소의 식별과 서술이 가능한 것으로 확인되어 본 연구에 적합하였다.
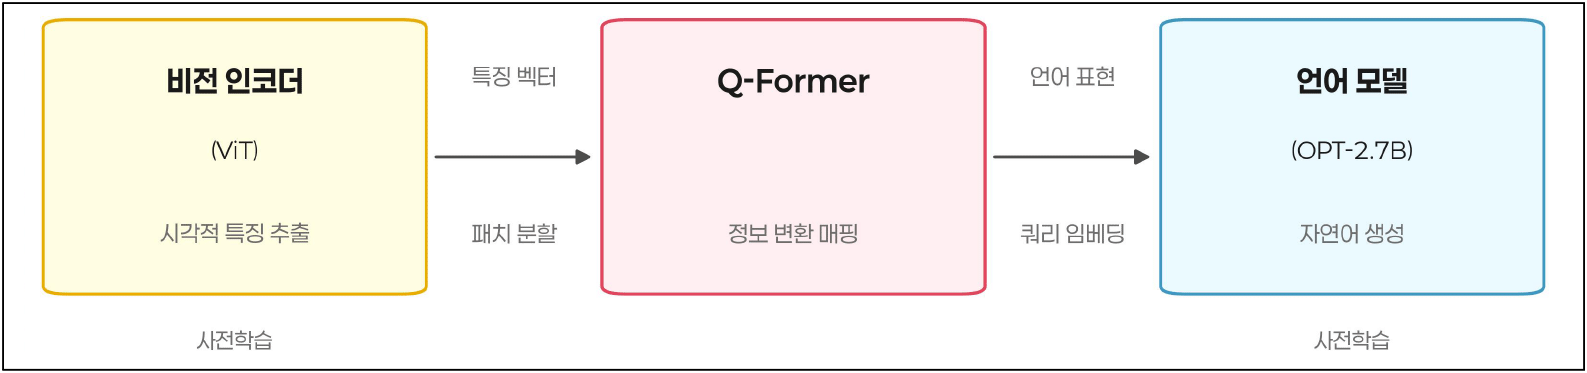
본 연구가 상용 멀티모달 대규모 언어모델 대신 공개 가중치 기반의 BLIP-2를 채택한 이유는 다음과 같다. 첫째, 고정된 버전의 가중치가 공개되어 있어 동일한 입력에 대한 재현이 보장되는 반면, 상용 API 기반 모델은 버전 갱신으로 재현이 어렵다. 둘째, 지자체 등 관리 주체가 자체 인프라에서 추가 비용 없이 반복 운용할 수 있어 경관 모니터링의 자동화에 유리하다. 셋째, 간결하고 정형화된 서술을 생성하여 대량 캡션의 키워드 빈도 분석에 적합하다.
본 연구에서는 Hugging Face에서 제공하는 blip2-opt-2.7b(Salesforce Research, 2023)를 사용하였으며, 캡션 생성 시 최대 토큰 길이는 50, 빔 서치 파라미터는 5로 설정하였다. 생성된 캡션은 이미지당 평균 10–20개의 단어로 경관의 시각적 요소와 공간적 배치를 서술하였다. 또한 생성된 캡션의 신뢰도를 확보하기 위해 각 정원 100장씩 총 200장을 난수 시드를 고정한 단순 무작위 추출로 선정하고, 사전에 정의한 판정 기준에 따라 200장 전량을 캡션과 이미지 일대일로 대조 검증하였다. 판정은 캡션의 핵심 대상과 장면이 이미지와 일치하면 ‘정확’, 핵심 대상은 일치하나 세부 서술에 불일치가 있으면 ‘부분오류’, 이미지에 없는 대상을 서술하였으면 ‘명백오류’로 구분하였다. 검증 결과 ‘정확’ 판정은 순천만 90장, 태화강 93장으로 전체 91.5%였고, 부분오류를 포함한 핵심 대상 일치율은 두 정원 모두 99.0%, 명백오류는 각 1장씩 전체 1.0%에 그쳤다. 두 정원의 정확도가 유사하여 캡션 오류가 특정 대상지에 편중될 가능성은 낮은 것으로 판단된다.
BLIP-2가 생성한 캡션에서 의미 있는 패턴을 도출하기 위해 텍스트 마이닝 기법을 적용하였다. 먼저 NLTK(natural language toolkit; Bird et al., 2009)를 활용하여 캡션을 토큰화하고 품사를 태깅하였다. 영어 불용어는 NLTK의 기본 불용어 목록을 사용했으며, 여기에 경관 대상이 아니라 화면 안의 위치·배치·크기·수량을 나타내는 서술어 20개(middle, front, background, foreground, left, right, top, bottom, next, near, behind, side, center, large, small, several, many, group, row, line)를 추가로 제거하였다. 이들 단어가 나타내는 배치와 구도 정보는 이미지 전체를 벡터로 표현하는 CLIP 임베딩 분석에서 다루어진다. 품사 태깅에서 명사와 형용사로 판정된 어휘를 모두 키워드로 취하였으며, WordNetLemmatizer를 통해 표제어 추출을 수행하였다. 형용사는 전체 키워드 토큰(순천만 5,994개, 태화강 4,095개)의 17.7%(순천만 1,061개, 태화강 725개)를 차지하였다. 형용사 가운데 색채(white, pink, red 등)가 47%–53%, 형태·질감(grassy, tall, wooden 등)이 27%–29%로 대부분이었고, beautiful과 같은 평가 형용사는 순천만 5회에 그쳐 캡션이 감성 평가가 아닌 물리적 경관 묘사에 집중함을 확인하였다. 유사어 병합은 영·미 철자 이형이나 색채 근접어가 자료에 나타나지 않아 적용하지 않았으며, colored → colorful, person → people, grassy → grass와 같은 병합 규칙을 적용해 본 경우에도 검정 결과는 변하지 않았다. 계절별 비교에 사용하는 키워드 다양성은 해당 계절의 전체 키워드 토큰 수 대비 키워드 종류 개수의 비율(%)로 정의하였다.
추출된 키워드는 전체 빈도 분석, 계절별 빈도 분석, 정원별 공통 및 특화 키워드 분석을 수행하였다. 키워드의 빈도는 캡션에 출현한 횟수로 집계하였고, 정원 간 비교에는 이미지 1,000장당 빈도와 해당 키워드가 출현한 이미지의 비율을 사용하였다. 이때 한쪽 정원에서만 출현한 키워드를 고유 키워드로, 양쪽 정원에 모두 출현하나 한쪽의 이미지 1,000장당 빈도가 다른 쪽의 3배 이상인 키워드를 특화 키워드로 조작적으로 정의하였다. 한편 오인식으로 판단되는 키워드도 임의로 제외하지 않았다. 이는 특정 키워드의 선별적 제거가 분석자의 주관에 따라 결과를 왜곡할 수 있기 때문이며, 오인식 키워드의 유형과 빈도는 캡션 검증에서 확인한 바와 같이 모두 저빈도 영역에 국한된다. 계절별 특성을 시각적으로 파악하기 위해 워드클라우드를 생성했으며, 각 계절별로 빈도 상위 30개 키워드를 추출하여 시각화하였다.
두 국가정원의 시각적 거리를 계산하고 거시적인 경관 특성을 정량화하기 위해 CLIP 모델 clip-vit-base-patch32(OpenAI, 2021)를 활용하여 두 국가정원 이미지의 512차원 특징 벡터를 추출하였다. 추출한 벡터는 코사인 거리 산출을 위해 L2 정규화하였다. 각 국가정원이 지닌 경관의 시각적 다양성을 객관적으로 비교하기 위해, 클러스터 내 분산도(intra-cluster dispersion)를 나타내는 평균 코사인 거리(average cosine distance to centroid)를 산출하였다. 이는 군집 중심점에 대한 평균 거리로, 값이 클수록 군집 내 이질성이 크다는 뜻이며 군집 응집도(cohesion)의 역지표에 해당한다(Tan et al., 2019). 여기에서 시각적 다양도 점수 D의 산출식은 식 1과 같다.
여기서 n은 특정 정원의 총 이미지 수, v는 i번째 이미지의 512차원 벡터, c는 해당 정원 군집의 중심점 벡터를 의미한다. 즉 이 점수가 높을수록 해당 대상지 내의 경관 요소들이 서로 높은 이질성을 띠며 시각적으로 폭넓게 분포하고 있음을 의미한다.
이후 도출된 고차원 데이터를 인간이 지각할 수 있도록 차원 축소 알고리즘인 UMAP(McInnes et al., 2018)을 적용하여 2차원 산점도로 시각화하였다. UMAP은 최근접 이웃 수(n_neighbors) 15, 최소 거리(min_dist) 0.1, 거리척도(metric) 코사인으로 설정하였으며, 결과의 재현을 위해 난수 시드(random_state)를 42로 고정하였다. UMAP은 고차원 임베딩의 근접 관계를 보존하도록 저차원에 투영하는 방법으로, 축의 눈금값이 아니라 점들 사이의 상대적 근접성이 해석 대상이 된다. 또한 하이퍼파라미터 설정에 따라 국지적 군집 형태가 달라질 수 있으므로, 본 연구에서는 군집의 절대적 위치나 거리가 아닌 상대적 분포 양상을 해석하였다. 또한, 두 정원의 군집 겹침 현상과 분리 명확도를 정량적으로 평가하기 위해 실루엣 점수(silhouette score, S; Rousseeuw, 1987)를 계산하였다. 실루엣 점수는 512차원 CLIP 임베딩 원공간에서 코사인 거리를 기준으로 산출하였으며, 이는 차원 축소 과정에서 발생할 수 있는 국지적 구조 왜곡의 영향을 받지 않도록 하기 위함이다. 개별 데이터 포인트 i에 대한 실루엣 계수 s(i) 및 전체 실루엣 점수 S의 산출식은 식 2와 같다.
여기서 a(i)는 데이터 i가 속한 군집 내 다른 데이터들과의 평균 거리(응집도), b(i)는 가장 가까운 타 군집 데이터들과의 평균 거리(분리도)이며, N은 전체 데이터 수이다. 실루엣 점수는 −1에서 1 사이의 값을 가지며, 1에 가까울수록 두 대상지가 명확히 분리되어 있음을, 0에 가까울수록 두 대상지의 교집합이 커 군집이 겹쳐 있음을 나타낸다.
이후 두 정원의 이미지가 임베딩 공간에서 어떤 하위 구조를 이루는지 파악하기 위해 UMAP 2차원 좌표에 밀도 기반 계층 군집화 알고리즘 HDBSCAN을 적용하였다(Campello et al., 2013; McInnes et al., 2017). 최소 군집 크기는 30, 최소 표본 수는 10으로 설정하였다. HDBSCAN은 군집 수를 미리 정하지 않고 밀도가 낮은 이미지를 노이즈로 분리하므로 촬영 조건이 다양한 방문자 이미지에 적합하다. 각 군집은 순천만 이미지 비중이 0.7 이상이면 순천만 우세, 0.3 이하이면 태화강 우세, 그 사이면 혼합 군집으로 분류하였고, 군집의 명칭은 중심점에 가장 가까운 대표 이미지와 다른 군집보다 출현 비율이 높은 특징 키워드를 저자가 검토하고 두 정원의 공식 정원 구성과 대조하여 부여하였다. 정원별 분포 구조는 노이즈 비율, 점유율 5% 이상 군집 수, 최대 군집 점유율, 군집 간 분포의 균등도를 0에서 1 사이로 나타내는 정규화 Shannon 엔트로피의 네 가지 지표로 요약하였다(Shannon, 1948; Pielou, 1966). 표본 수와 계절 구성의 차이가 이 지표에 미치는 영향을 통제하기 위해, 두 정원에서 같은 수의 이미지를 무작위 추출하여 군집화를 반복하는 리샘플링(resampling)을 30회, 계절별로 같은 수를 추출하는 리샘플링을 100회 수행하였다(Gotelli and Colwell, 2001). 군집 결과의 강건성은 최소 군집 크기를 20으로, 최소 표본 수를 5와 20으로, UMAP 난수 시드를 다른 값으로 바꾸어 다시 산출한 결과 및 k-means 결과가 기본 설정 군집과 일치하는 정도로 확인하였으며, k-means의 군집 수는 15로 두었다. 일치도는 Strehl and Ghosh(2002)의 정규화 상호정보량(NMI)으로 산출하였으며, NMI는 두 군집 결과가 완전히 일치하면 1, 서로 독립이면 0의 값을 갖는다.
키워드 출현 비율의 정원 간 차이, BLIP-2가 서술한 garden·park 어휘의 시각적 타당성, BLIP-2 키워드 분류와 CLIP 군집의 일치 여부를 확인하기 위해 카이제곱 검정, CLIP 제로샷 판정과 로지스틱 회귀, 텍스트 분석과 NMI 산출을 수행하였다. 각 절차는 다음과 같다.
첫째, 키워드 출현 비율의 정원 간 차이는 이미지 단위 출현 여부를 기준으로 2×2 교차표를 구성하여 Yates 연속성 보정 카이제곱 검정으로 검정하였고, 효과크기는 Cramér의 V로 제시하였다(Cramér, 1946). 검정 대상은 상위 15개 키워드 가운데 정원과 공원의 경관 특성을 지시하는 어휘(garden, park), 각 정원의 대표 자연자원(bamboo, forest), 두 정원에 공통인 자연 요소(flower, tree, field, water)의 8개이며, 사람·색채·형태를 나타내는 서술어와 개별 시설물은 제외하였다. 8개를 동시에 검정하므로 Bonferroni 보정을 적용하였다(α = 0.00625).
둘째, garden과 park 어휘가 이미지의 시각적 차이에 대응하는지는 CLIP으로 검증하였다. CLIP 텍스트 인코더로 정원 프롬프트 5개(‘a photo of a garden’, ‘a flower garden’ 등)와 공원 프롬프트 5개(‘a photo of a park’, ‘a riverside park’ 등)의 임베딩을 구하고, 각 이미지와 두 프롬프트 집합 간 평균 코사인 유사도를 비교하여 garden 여부를 판정하는 제로샷 분류를 수행하였다(Radford et al., 2021). 이 판정과 BLIP-2 라벨의 일치도는 두 어휘가 함께 서술된 5장을 제외하고 ROC 곡선 아래 면적(AUC)으로 산출하였으며, AUC는 0.5가 우연 수준, 1이 완전 판별을 뜻한다. 이어 512차원 CLIP 임베딩으로 두 라벨을 구분하는 로지스틱 회귀(logistic regression)모형을 학습시키고1), 같은 정원 안에서는 5-fold 교차검증 AUC로, 정원 간에는 한 정원에서 적합한 모형을 다른 정원에 적용한 전이 AUC로 판별력을 평가하였다. 아울러 garden 또는 park가 서술된 이미지가 어느 군집에 분포하는지를 교차 집계하였다.
셋째, BLIP-2 키워드 분류와 CLIP 군집의 일치 여부는 두 가지 텍스트 분석으로 확인하였다. 10장 이상의 이미지에 출현한 키워드를 대상으로 같은 캡션에 5회 이상 함께 나타난 키워드 쌍을 연결한 공기어 네트워크에 Louvain 알고리즘(Blondel et al., 2008)을 적용하여 키워드 집단(community)을 도출하였고, LDA 토픽모델(Blei et al., 2003)로 캡션의 주제를 추출하되 주제 수는 응집도 점수가 가장 높은 13개로 정하였다. 두 분류와 CLIP 군집 간 일치도는 NMI로 산출하였다.
4. 결과 및 고찰
계절별 리뷰 분포(전체 리뷰 기준)는 순천만이 봄 246건(27.1%), 여름 153건(16.9%), 가을 418건(46.1%), 겨울 90건(9.9%)으로 가을에 집중된 반면, 태화강은 봄 163건(32.7%), 여름 99건(19.9%), 가을 162건(32.5%), 겨울 74건(14.9%)으로 봄과 가을이 균등하였다. 특히 순천만은 10월 리뷰가 202건으로 연중 최고치를 기록하였다. 분석 이미지 기준으로는 순천만이 봄 434장, 여름 244장, 가을 689장, 겨울 185장, 태화강이 봄 369장, 여름 237장, 가을 296장, 겨울 113장이었다.
BLIP-2를 통해 생성된 캡션에서 추출한 키워드를 분석한 결과, 순천만국가정원은 전체 907개 리뷰 중 이미지가 첨부된 578개 리뷰(1,552장)에서 480종의 키워드가, 태화강국가정원은 전체 498개 리뷰 중 이미지가 첨부된 258개 리뷰(1,015장)에서 358종의 키워드가 도출되었다. 다만 키워드 종수는 분석 이미지 수에 따라 증가하되 그 증가가 점차 둔화되므로, 표본 크기를 통제하기 위해 순천만 이미지를 태화강과 같은 1,015장으로 무작위 축소하여 키워드 종수를 다시 세는 희박화(rarefaction)를 200회 반복하였다(Gotelli and Colwell, 2001). 그 결과 순천만의 종수는 408 ± 9종(95% 구간 393–424종)으로 태화강 358종보다 다소 많았다. 즉 종수의 차이는 표본 수를 맞추어도 일부 남으나, 두 정원의 차이는 종수보다 어떤 경관 요소가 촬영되는가라는 구성의 차이에서 뚜렷하며, 본 연구는 이에 초점을 맞추어 두 정원을 비교하였다. 태화강의 동일 기간 부분집합(405장)에서도 전체 기간의 상위 15개 키워드는 모두 상위 20위 이내에 포함되었고, 상위 30개 키워드의 순위 상관은 ρ = 0.88(p < 0.001)으로 나타났다.
그림 3은 두 정원의 상위 15개 키워드를 비교한 것이다. 순천만은 flower(367회)가 압도적 1위였으며, tree(295회), field(270회), park(207회)가 뒤를 이었다. 태화강은 field(244회), bamboo(220회), tree(204회), flower(202회) 순으로 나타났으며, 특히 bamboo가 2위를 차지하여 대나무숲이 대표적 경관임을 보여준다. 특히 순천만에서 garden(168회)이 6위로 높게 나타난 반면, 태화강에서는 25회에 그치는 것으로 나타났다.
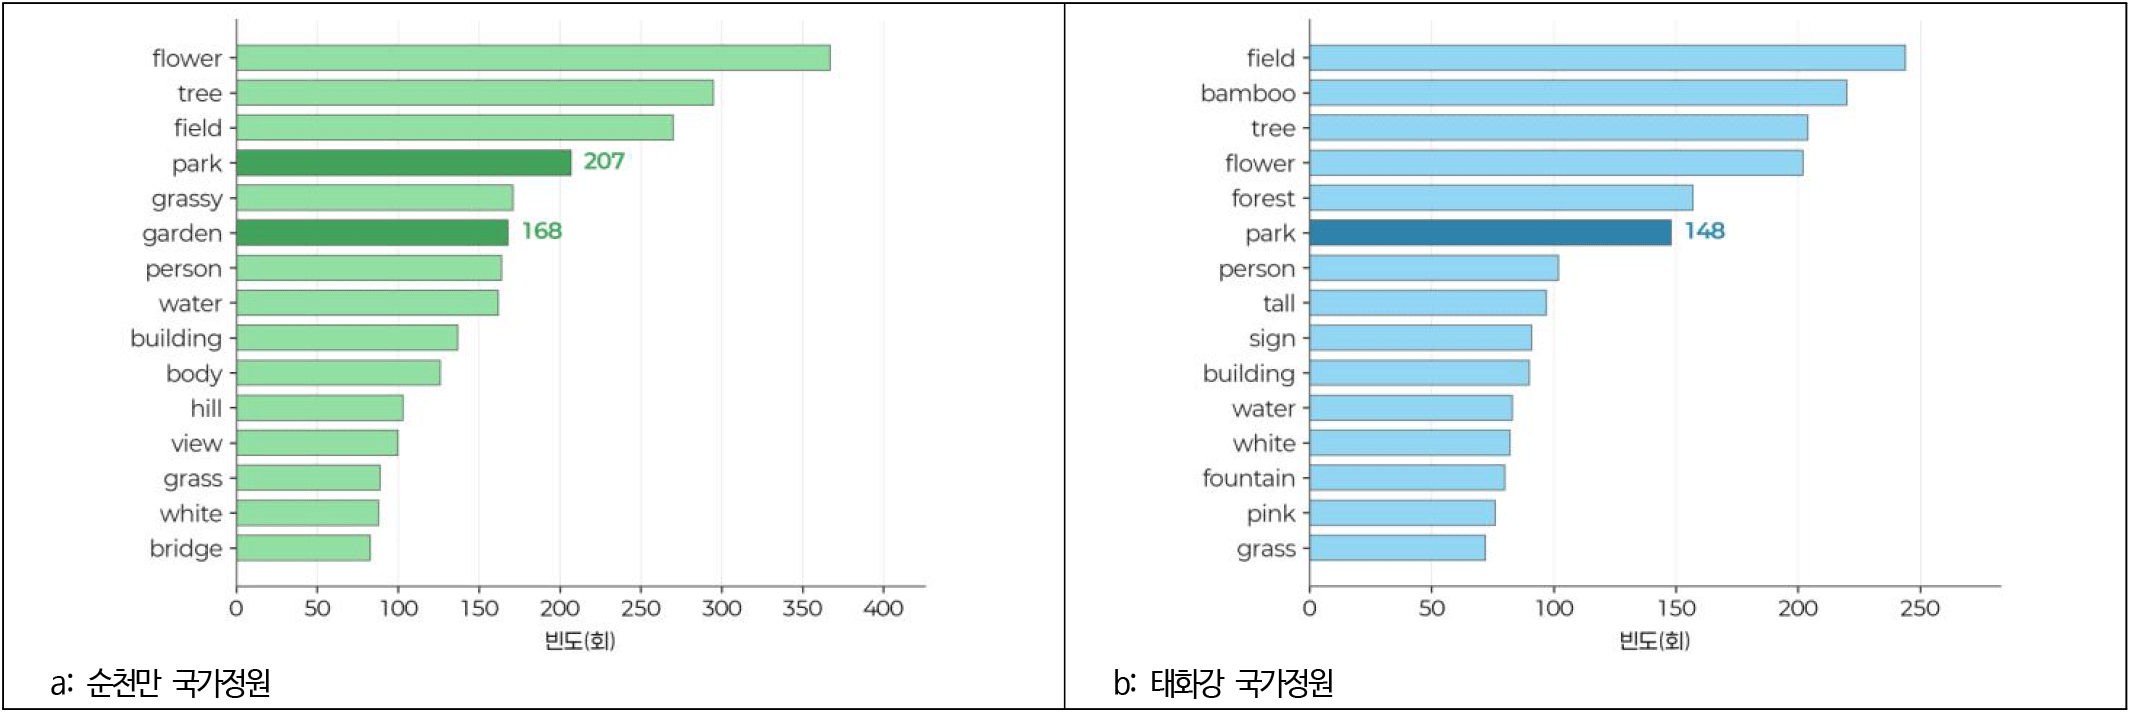
전체 키워드 분석 결과, 223개의 공통 키워드와 함께 순천만 257개, 태화강 135개의 고유 키워드가 확인되었다. 순천만의 고유 키워드는 flamingo(50회), windmill(44회), dome(19회), waterfall(18회) 등으로 다양한 테마정원과 조형물이 특징적이다. 태화강의 고유 키워드로는 forest(157회)가 대표적이며, 양쪽 정원에 모두 출현하나 한쪽에 편중된 특화 키워드로는 순천만의 garden(1,000장당 순천만 108.2회, 태화강 24.6회로 4.4배)과 태화강의 bamboo(1,000장당 태화강 216.7회, 순천만 7.1회로 30.6배), fountain(1,000장당 태화강 78.8회, 순천만 14.2회로 5.6배)이 확인되어, 십리대숲과 무지개분수가 주요 경관 요소임을 시사한다. 공간 인식 측면에서 park는 두 정원 모두 높게 나타났으나(순천만 207회, 태화강 148회), garden은 순천만(168회)이 태화강(25회)보다 6.7배 높아 명확한 경관 특성 차이를 보였다. 표본 크기를 통제한 이미지 1,000장당 빈도로 환산하여도 garden은 순천만 108.2회, 태화강 24.6회로 4.4배의 차이가 유지된 반면, park는 순천만 133.4회, 태화강 145.8회로 두 정원이 유사한 수준이었다.
표 2는 각 키워드가 출현한 이미지의 비율이 두 정원 간에 우연 수준을 넘어 다른지를 앞서 기술한 방법으로 검정한 결과로, χ2와 V가 클수록 그 키워드가 두 정원을 변별하는 정도가 크다는 것을 의미한다. garden은 순천만 10.7%, 태화강 2.5%로 유의한 차이를 보였고(χ2 = 59.2, p < 0.001), bamboo와 forest는 각각 χ2 = 305.3, χ2 = 237.5로 더욱 뚜렷하였다. 효과크기는 bamboo(V = 0.345)와 forest(V = 0.304)에서 가장 컸으며 garden(V = 0.152)이 뒤를 이었다. 반면 park(순천만 13.3%, 태화강 14.6%)와 flower, tree에서는 두 정원 간 차이가 확인되지 않았고, field와 water는 명목상 유의하였으나 효과크기가 V = 0.074 이하로 작았고, water(p = 0.026)는 Bonferroni 보정 후에는 유의하지 않았다. 모든 셀의 기대빈도가 5 이상이었고, Bonferroni 보정을 적용하여도 garden·bamboo·forest·field의 유의성은 유지되었다. 즉 두 국가정원의 차이는 park의 출현 비중이 아니라 garden의 출현 비중에서 두드러졌다.
순천만은 겨울을 제외한 모든 계절에서 flower가 압도적 1위를 유지하였다(봄 121회, 여름 63회, 가을 175회)(그림 4 참조). 특히 봄에는 tulip(38회)이 6위에 올라 계절 특화 화훼를 보여주었고, garden은 봄(56회)과 여름(30회)에 4–6위를 유지하며 정원과 관련된 경관 특성을 지속적으로 나타냈다. 겨울에만 tree(45회)가 1위가 되었으나, 여전히 garden(17회)이 8위에 위치해 계절과 무관한 정원 인식을 보여주었다.
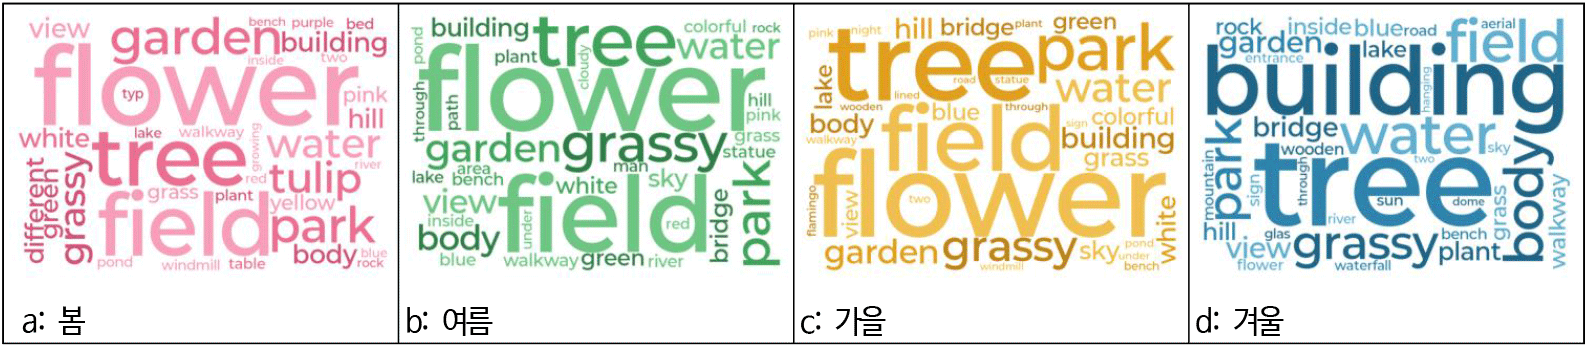
계절별 대표 캡션은 다음과 같다. 봄(5월)은 “a group of people standing in front of a flower garden”, 여름(8월)은 “a field full of red and yellow flowers with a bridge in the background”, 가을(11월)은 “colorful flowers and trees in a garden”, 겨울(2월)은 “a walkway inside of a building with plants and trees”로 나타났다. 키워드 다양성은 겨울에 27.2%로 가장 높고 가을에 11.9%로 가장 낮았는데, 이는 가을의 flower 중심 경관 집중을 반영한다.
반면 태화강은 계절에 따라 주요 키워드가 변화하였다(그림 5 참조). 봄에는 flower(107회)와 field(107회)가 동률 1위를 차지했고, red(51회), pink(35회), poppy(30회) 등 화훼 관련 키워드가 상위에 올랐다. 여름에는 park(56회)가 1위로 올라 도시공원적 이용이 증가했으며, fountain(26회)은 무지개분수 관람을, night(17회)는 야간 이용을 반영하여 각각 특징적으로 나타났다. 가을에는 field(95회)가 다시 1위가 되었고, 겨울에는 bamboo(41회)와 forest(33회)가 상위를 차지해 십리대숲이 겨울 주요 경관임을 보여주었다.
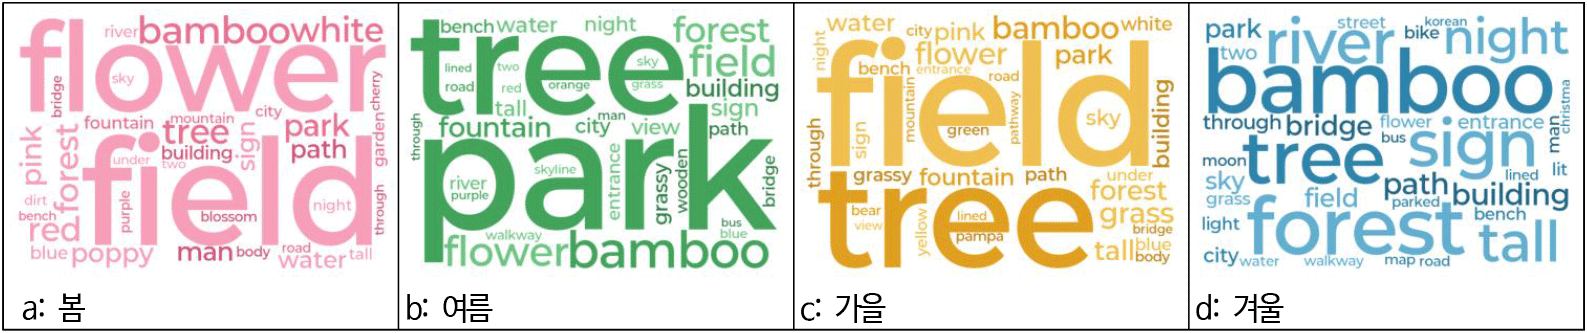
계절별 대표 캡션은 다음과 같다. 봄(5월)은 “a field full of red poppies”, 여름(6월)은 “a fountain in a park surrounded by grass and trees”, 가을(10월)은 “purple grasses and trees in a field under a blue sky”, 겨울(12월)은 “a dirt road that is lined with bamboo trees”로 나타났다. 키워드 다양성은 태화강 역시 겨울에 26.3%로 가장 높았다. 다만 겨울은 분석 이미지가 순천만 185장, 태화강 113장으로 가장 적고, 토큰 수 대비 종류 개수로 정의한 이 지표는 표본이 작을수록 높아지는 경향이 있으므로, 겨울의 높은 값은 표본 크기의 영향을 함께 고려하여 해석할 필요가 있다.
CLIP 임베딩 공간에서 식 1에 따라 두 대상지의 시각적 다양도(분산도) 점수를 산출한 결과, 순천만은 0.2120, 태화강은 0.2119로 나타났다. 이는 두 정원 모두 계절 변화와 다양한 방문객 활동에 의해 파생되는 전체적인 시각적 스펙트럼의 총량은 거의 같은 수준임을 보여준다. 나아가 512차원 CLIP 임베딩 원공간에서 두 정원을 집단으로 놓고 산출한 실루엣 점수는 0.0279로 도출되었다. 이는 0에 근접한 양수 값으로 두 대상지가 넓은 잔디밭, 수목 등 공원의 시각적 특성을 공통적으로 공유하며, 거대한 교집합을 이루고 있음을 정량적으로 확인시켜 준다.
UMAP 좌표에 HDBSCAN을 적용한 결과 21개 군집이 도출되었고, 전체 이미지의 24.9%는 어느 군집에도 속하지 않는 노이즈로 분류되었다(그림 6 참조)4). 그림 6의 두 축은 512차원 임베딩의 근접 관계를 2차원에 투영한 것이므로 축의 값이 아니라 점의 분포 양상이 해석 대상이다. 군집별 정원 구성은 순천만 우세 군집 10개, 태화강 우세 군집 8개, 혼합 군집 3개로 나타났다(표 3 참조). 순천만 우세 군집은 호수정원, 온실, 실내 체험, 정형식 정원 등 기획되고 연출된 요소를, 태화강 우세 군집은 십리대숲, 무지개분수, 강변 도시경관과 핑크뮬리, 양귀비, 벚꽃 등 자연 기반 자원과 계절 초화를 주로 포함하였다. 혼합 군집인 꽃 근접 촬영, 안내판, 수변 풍경은 두 정원의 방문자가 공통으로 촬영하는 대상이었다. 정원별로 보면 순천만 이미지의 63.7%가 순천만 우세 군집에 속한 반면, 태화강 이미지는 43.4%가 태화강 우세 군집, 12.9%가 순천만 우세 군집에 속하였다.
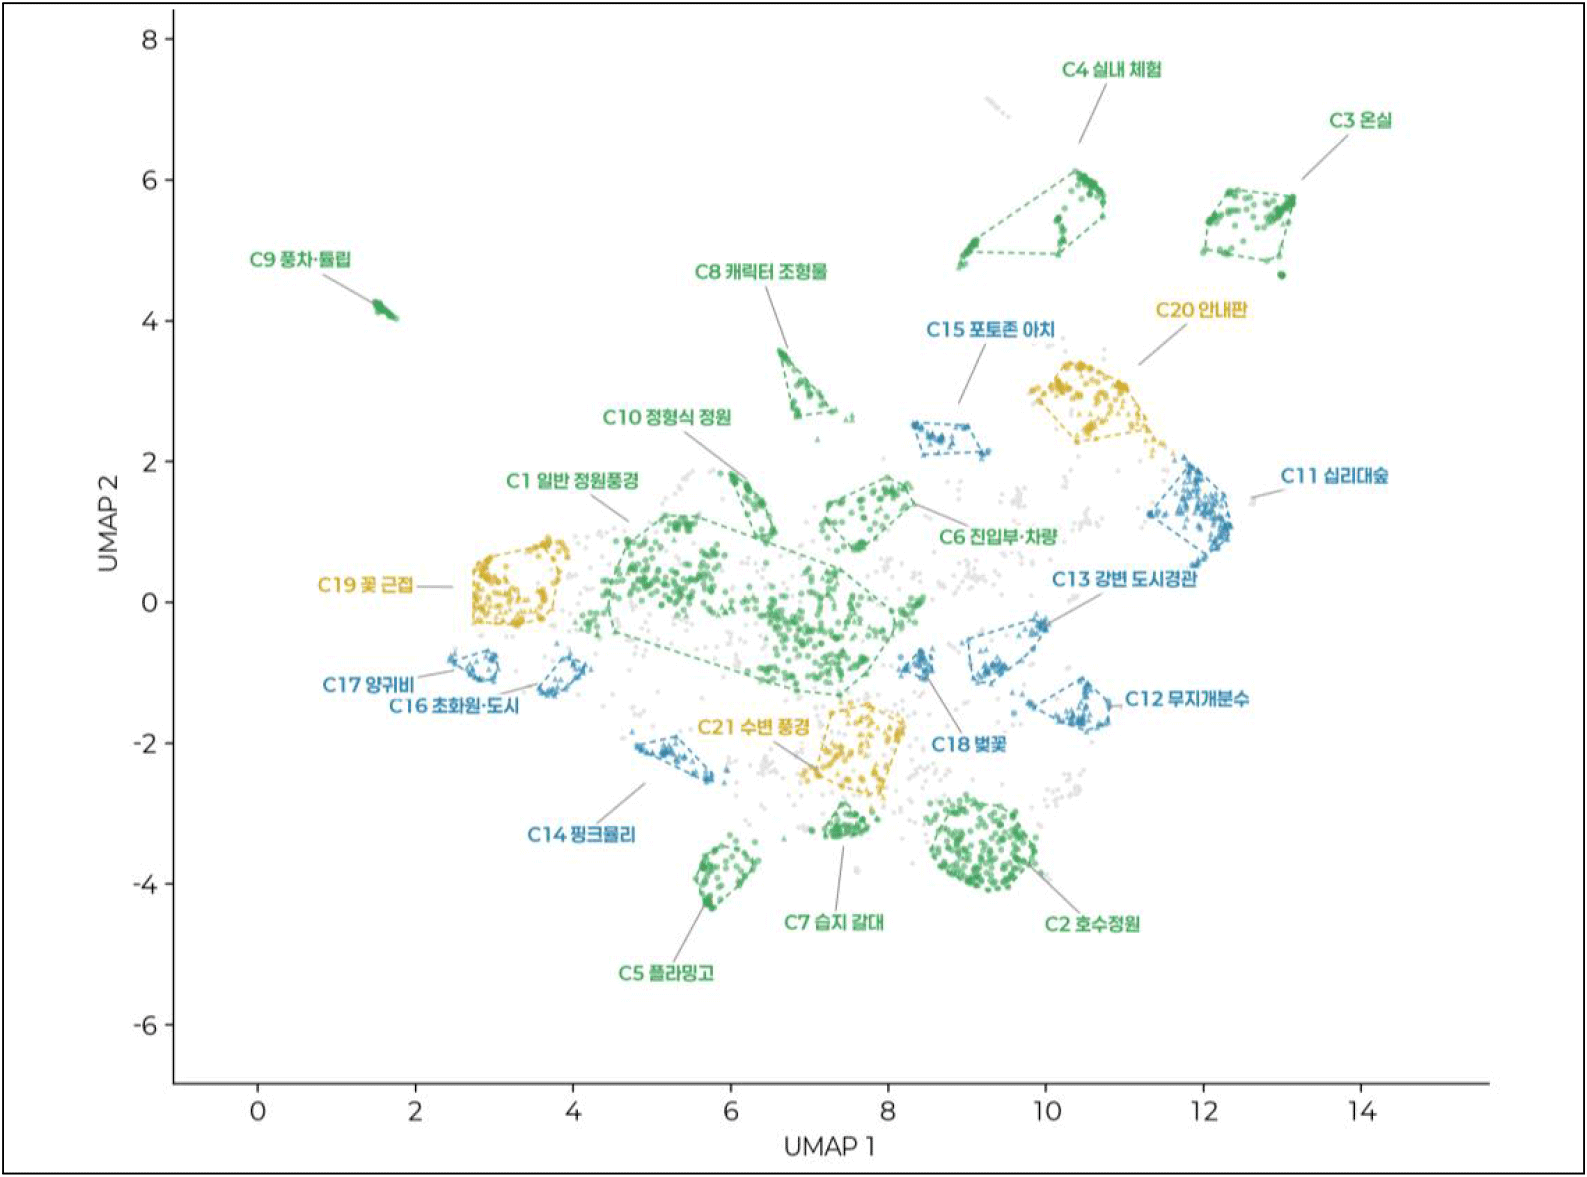
전체 자료에서 순천만 우세 군집이 더 많이 나타난 것은 표본 수의 영향을 받을 수 있으므로, 표본 수와 계절 구성을 맞춘 리샘플링으로 재확인하였다. 두 정원에서 같은 수(1,015장)의 이미지를 추출하여 군집화를 반복한 결과 정원별 우세 군집 수(순천만 6.0 ± 2.1개, 태화강 6.6 ± 2.9개)와 정규화 Shannon 엔트로피(0.75와 0.76)는 차이가 없었고, 계절 구성까지 맞춘 리샘플링에서도 우세 군집 수와 다양도는 유사한 수준이었다. 즉 군집 수와 다양도는 두 정원이 유사하였고, 두 조건에서 일관되게 확인된 차이는 정원별 우세 군집을 구성하는 경관 유형이었다. 이는 키워드 종수보다 구성에서 차이가 뚜렷하였던 키워드 분석 결과와 같은 경향을 보인다. 군집 결과는 최소 군집 크기, 최소 표본 수, UMAP 난수 시드를 바꾸어도 기본 설정과 NMI 0.93 이상으로 일치하였고, k-means와의 일치도는 NMI 0.68이었다. 태화강의 동일 기간 부분집합에서도 군집 점유율 순위(ρ = 0.94)와 군집 구성(NMI 0.90)이 전체 기간과 일치하였고, 다양도 D만 전체 기간보다 소폭 낮았다(0.2056과 0.2119).
BLIP-2가 서술한 garden과 park 어휘가 촬영된 장면의 시각적 차이에 대응하는지 BLIP-2와 독립된 CLIP으로 검증하였다(표 4 참조). 두 어휘가 서술된 이미지는 CLIP 제로샷 판정과 로지스틱 회귀 모두에서 높은 판별력(AUC 0.93 이상)으로 구분되었고, 한 정원에서 적합한 모형을 다른 정원에 적용하여도 판별력이 유지되었다. 군집별로는 garden이 정형식 정원, 온실, 포토존 아치 군집에, park가 무지개분수, 강변 도시경관, 수변 풍경 군집에 집중되어, 두 어휘는 각각 연출된 정원 요소와 개방 녹지 요소를 가리켰다. 따라서 BLIP-2가 선택한 어휘는 촬영된 장면의 시각적 특성을 반영하며 두 국가정원의 특징 차이에 대응하는 것으로 확인되었다.
| 구분 | 검증 내용 | 지표5) | 순천만 | 태화강 | 전체 |
|---|---|---|---|---|---|
| garden․park* 어휘 검증 | CLIP 제로샷 판정으로 BLIP-2 라벨 구분 | AUC | 0.93 | 0.94 | – |
| CLIP 임베딩 로지스틱 회귀(5-fold 교차검증) | AUC | 0.93 | 0.93 | – | |
| 다른 정원의 모형 적용(전이) | AUC | 0.85 | 0.92 | – | |
| CLIP 제로샷 garden 판정 | 비율(%) | 37.7 | 29.1 | χ2 = 19.9, p < 0.001 | |
| 텍스트 분류와 CLIP 군집의 일치 | 최다 공출현 키워드 쌍 | 공출현 이미지 수 | flower–garden 97 | bamboo–forest 146 | – |
| 공기어 네트워크 키워드 집단과 CLIP 군집 | NMI | 0.28 | 0.31 | 0.37 | |
| LDA 주제와 CLIP 군집 | NMI | 0.28 | 0.38 | 0.29 | |
| 무작위 순열(우연 수준) | NMI | 0.02–0.04 | 0.02–0.06 | 0.02–0.03 |
또한 BLIP-2 캡션에 기반한 키워드 분류와 CLIP 군집이 이미지를 같은 방식으로 분류하는지 확인하기 위해 공기어 네트워크의 키워드 집단과 LDA 주제를 CLIP 군집과 대조하였다. 두 텍스트 분류 모두 CLIP 군집과 우연 수준을 크게 상회하는 일치를 보였고, 최다 공출현 쌍(순천만 flower-garden, 태화강 bamboo-forest)도 키워드 분석에서 확인한 구성 차이와 같았다. 일치하지 않은 부분은 두 방법의 역할 차이에서 비롯되었다. 텍스트 분류는 같은 어휘를 공유하는 장면(십리대숲과 안내판, 양귀비와 초화원)을 하나로 묶은 반면, CLIP 군집은 이를 시각적 하위 유형으로 나누었다. 따라서 두 방법은 두 정원의 경관 구조를 같은 방향으로 분류하였으며, 두 결과는 일관된 것으로 확인되었다.
본 연구는 BLIP-2, CLIP 기반 이미지 캡셔닝, 임베딩을 통해 두 국가정원의 경관 특성 차이를 비교하였다. 분석 결과는 두 정원의 상이한 조성 배경을 일관되게 반영하며, 그 양상은 촬영된 경관 요소의 구성, 계절에 따른 변동, 이미지 전체의 시각적 구조라는 세 층위에서 확인된다.
첫째, 촬영된 경관 요소의 구성에서 두 정원은 뚜렷한 차이를 보였다. 주목할 점은 ‘garden’과 ‘park’ 키워드의 상대적 비중 차이다. bamboo와 forest는 특정 자연자원의 물리적 존재 여부를 반영하므로 두 정원에서 배타적으로 나타난 반면, garden은 두 정원 모두에 나타날 수 있는 속성임에도 유의한 차이를 보였다는 점에서 정원의 경관을 변별하는 지표로서 의미를 지닌다. 이는 순천만이 국제정원박람회를 계기로 계획적으로 조성된 반면(김준선, 2016) 태화강은 기존 도시공원에서 전환된 조성 배경의 차이를 반영하는 결과로, 태화강이 도시공원의 틀을 유지한 채 국가정원으로 전환되어 도시공원의 경관을 유지하고 있는 특성을 보이는 것을 시사한다. 최정원 등(2023)이 지적한 설치 시기별 관리주체의 차이도 이러한 경관 특성의 차이와 연관된다고 할 수 있다.
둘째, 계절에 따른 키워드 변동성에서도 차이가 확인되었다. 순천만은 겨울을 제외한 세 계절에서 flower가 1위를 유지하였는데, 이는 체계적인 화훼 전시 운영이 계절에 따른 편차를 줄이고 일관된 정원 경험을 창출할 수 있음을 시사한다. 반면 태화강은 계절에 따라 주요 경관 요소가 교체되는 구조를 보였으며(봄: flower/field, 여름: park, 겨울: bamboo/forest), 특히 겨울에는 십리대숲 등 특정 자연자원에 경관 인식이 집중되었다. 즉 순천만의 촬영 대상은 화훼 전시 운영에 의해 계절과 관계없이 유지되는 반면, 태화강의 촬영 대상은 초화의 개화기와 대숲 등 자연 자원의 계절성에 영향을 많이 받는 것으로 나타났다.
셋째, 이미지 전체의 시각적 구조에서는 두 정원의 시각적 다양도가 유사하였고 실루엣 점수도 0에 가까워 두 정원의 이미지가 상당 부분 중첩되었으며, 표본을 균형화한 뒤에도 군집 수와 다양도는 유사한 수준이었다. 반면 정원별 우세 군집을 구성하는 경관 유형에는 차이가 나타났다. 순천만 우세 군집이 호수정원, 온실, 실내 체험, 풍차, 정형식 정원, 조형물 등 기획되고 연출된 공간을 주로 포함한 것은 키워드 분석에서 나타난 테마정원과 조형물 중심의 구성과 일치하며, Kaplan and Kaplan(1989)에 따르면 이러한 연출된 시각적 복잡성은 방문객에게 새로운 자극을 주어 공간의 매력도를 높이는 요인으로 논의되어 왔다. 태화강 우세 군집이 십리대숲, 무지개분수, 강변 도시경관과 양귀비, 핑크뮬리, 벚꽃 등 단일 계절의 초화 군락으로 구성된 것은 특정 자연 기반 자원과 계절 초화가 만들어 내는 경관에 의존함을 보여준다. 이러한 우세 군집은 두 정원의 공식 정원 구성과 대체로 대응하여, 순천만의 호수정원, 온실, 정형식 정원, 풍차·튤립은 호수정원, 세계정원, 온실이라는 기획 시설에, 태화강의 십리대숲, 무지개분수, 강변 도시경관, 핑크뮬리와 양귀비는 대나무정원, 수생정원(오산못), 하천 양안의 개방 공간, 계절정원의 초화원에 해당한다. 다만 공간 구조를 직접 측정하지 않았으므로 이 대응은 정성적으로 해석할 필요가 있으며, 습지 갈대 군집처럼 인접 순천만습지의 경관이 순천만 리뷰에 일부 포함된 점도 고려할 필요가 있다. 이처럼 키워드 분석과 군집 분석의 결과는 같은 경향을 보였다.
이상을 종합하면, 두 정원의 차이는 세 층위에서 확인되었다. 촬영된 경관 요소의 구성에서는 garden과 park 어휘의 비중 차이가 경관 특성의 차이를 드러냈고, 계절 변동에서는 순천만이 화훼 전시 운영으로 계절과 관계없이 촬영 대상을 유지한 반면, 태화강은 자연 자원의 계절성에 따라 촬영 대상이 바뀌었으며, 이미지 전체의 시각적 구조에서는 두 정원이 오픈스페이스 경관의 공통 구성을 공유하는 가운데 정원별 우세 군집을 이루는 경관 유형에서 구분되었다. 즉 두 국가정원은 공원으로서의 기본 골격을 공유하면서도 정원으로서의 경관 특성은 구분된다고 할 수 있다.
이러한 결과는 두 정원의 경관 관리 방향을 다음과 같이 시사한다. 첫째, 태화강은 계절 연속성의 확보가 과제이다. 겨울 이미지의 65.8%가 십리대숲(34.2%), 안내판(17.1%), 강변 도시경관(14.5%)의 세 군집에 집중되었고, 양귀비, 핑크뮬리, 벚꽃 군집은 각각 한 계절에만 나타났다. 이는 태화강 SNS 게시물이 겨울에 9.9%에 그치고 해시태그가 십리대숲과 은하수길에 집중되었다는 분석(박재영 등, 2022), 태화강의 주제정원 다양성과 식생 계절성이 순천만보다 낮게 평가된 결과(권진욱과 최동아, 2024), 계절 의존 정원의 낮은 평가(송즈쉬앤과 이혁재, 2023), 전 구간에 계절과 관계없는 볼거리가 필요하다는 지적(최정원 등, 2023)과 부합한다. 따라서 초화 군락의 개화 시기가 이어지도록 식재 구성을 조정하고, 비개화기에도 촬영 대상이 될 수 있는 구조물·수경·야간경관을 보완할 필요가 있다. 이는 울산연구원이 2028 국제정원박람회 연계 경관사업으로 제시한 시민 체감형 콘텐츠 보강과 야간경관 특화(신한나, 2026)와 같은 방향이며, 시민 조사에서 체험 요소 부족(40.8%)과 야간조명 미흡(22.3%)이 주요 개선 요구로 나타난 점과도 부합한다.
둘째, 순천만은 봄과 여름의 경관 기록을 보강할 필요가 있다. 겨울에도 호수정원과 온실이 촬영 대상을 유지하여 수경과 실내 요소가 비수기를 지탱하였으나, 온라인 리뷰가 가을(10월, 202건)에 집중되어 봄과 여름의 경관 기록이 상대적으로 적다. 봄·여름 특화 프로그램은 기록되는 경관의 계절 편중을 완화하는 방향이 된다.
셋째, 두 정원이 공유하는 혼합 군집(꽃 근접 촬영, 안내판, 수변 풍경)은 방문자가 공통으로 촬영하는 대상이므로, 화단 근접 관람 동선, 안내체계, 수변 조망점의 유지관리는 두 정원 모두의 기본 과제이다.
넷째, 순천만은 유료, 태화강은 무료로 운영되어 방문의 목적성과 촬영 행태가 다를 수 있다. 태화강 방문자에게 휴식과 기분전환 동기가 두드러진 점(이지선과 서주환, 2024)을 고려하면, 태화강의 정원 콘텐츠 보강은 일상 이용 속에서 정원 경험을 제공하는 방향을 함께 검토할 필요가 있다.
본 연구의 한계는 다음과 같다. 첫째, 소셜미디어 자료는 무작위 표본이 아니므로(Tenkanen et al., 2017; Hargittai, 2020), 결과는 온라인에 경관을 기록·공유하는 이용자층의 인식으로 해석해야 한다. 둘째, 두 정원은 분석 이미지 수와 수집 기간이 다르며, 태화강 자료에는 다년도와 코로나19 시기가 포함된다. 이미지 수 차이는 이미지 수를 맞춘 키워드 종수 비교와 리샘플링으로, 기간 차이는 동일 기간 부분집합과 계절 구성을 맞춘 리샘플링으로 통제하였고 주요 결과가 유지되었으나, 두 정원의 비교는 직접적 대비보다 경향적 비교로 읽어야 한다. 셋째, 촬영 조건이 통제되지 않았고 캡션 어휘는 모델의 어휘 배분 경향을 일부 반영할 수 있으므로, 제로샷 판정으로 교차 확인하였더라도 향후 방문자 설문과의 결합 검증이 필요하다. 또한 캡션의 형용사가 색채와 형태 등 물리적 묘사에 집중하므로, 방문자의 정서적 평가 차원은 설문이나 평점 자료와 결합하는 후속 연구에서 다룰 필요가 있다. 넷째, 두 정원의 물리 구조는 공식 정원 구성과 공간 형태 수준에서 비교하였으므로, 향후 정원별 면적, 식재 밀도, 동선 등 공간 구조를 정량화하여 군집 결과와 대응시키는 연구가 필요하다.
5. 결론
본 연구는 BLIP-2와 CLIP 기반 멀티모달 인공지능 기술을 적용하여 순천만국가정원과 태화강국가정원의 경관 특성 차이를 비교하였다.
연구의 주요 결과는 다음과 같다. 첫째, garden과 park 키워드의 상대적 비중이 두 정원의 경관 특성 차이를 드러내는 지표로 나타났다. 이미지 1,000장당으로 환산하면 순천만은 garden 108.2회와 park 133.4회가 비슷한 수준을 이룬 반면, 태화강은 park 145.8회가 garden 24.6회의 약 5.9배로 공원적 성격이 두드러졌다. 둘째, 표본 수를 1,015장으로 맞춘 키워드 종수는 순천만 408종, 태화강 358종으로 차이가 크지 않았으나, 그 구성은 순천만이 화훼·조형물 중심, 태화강이 bamboo·forest 중심으로 대비되었다. 셋째, CLIP 임베딩의 밀도 기반 군집 분석에서 표본을 균형화한 뒤 두 정원의 군집 수와 다양도는 유사한 수준이었고, 정원별 우세 군집을 구성하는 경관 유형에서 차이가 나타났다. 순천만 우세 군집은 기획된 시설 중심, 태화강 우세 군집은 자연 기반 자원과 계절 초화 중심으로 구성되어 키워드 분석과 같은 경향을 보였다. 넷째, 키워드 출현 비율 검정에서 garden·bamboo·forest는 유의한 차이를 보인 반면 park·flower·tree는 유의한 차이가 없었고 field·water는 효과크기가 미미하였다. 이를 통해 두 정원이 오픈스페이스 경관의 공통 요소를 공유하면서도 각 국가정원의 특정 경관 요소에서는 구분되는 부분이 있음을 확인하였다.
정책적으로 태화강은 겨울 촬영 경관이 십리대숲에 집중되고 초화 군락이 단일 계절에 그치므로, 초화 군락의 개화 시기가 이어지도록 식재 구성을 조정하고, 비개화기에도 촬영 대상이 될 수 있는 구조물·수경·야간경관을 보완하는 방안을 검토할 필요가 있다. 순천만은 겨울에도 호수정원과 온실이 촬영 대상으로 유지되어 경관 콘텐츠 자체는 계절과 무관하게 일관되었으나 온라인 리뷰는 가을에 집중되어 있으므로, 이미 확보된 콘텐츠를 봄·여름 프로그램으로 연결하여 방문의 계절 편중을 완화할 여지가 있다. 두 정원이 공유하는 꽃 근접 관람, 안내체계, 수변 조망점은 공통의 기본 관리 대상이다.
본 연구는 텍스트와 시각 정보를 결합한 분석이 기존의 선호도 설문조사나 전문가 경관 평가를 보조하는 도구로 활용될 수 있음을 보여주었다. 특히 CLIP 임베딩 군집으로 시각적으로 유사한 장면을 분류하고 BLIP-2 캡션 어휘로 각 군집을 경관 유형으로 해석한 뒤 경관 유형 단위로 두 정원을 비교함으로써, 순천만은 기획된 시설 중심, 태화강은 하천 기반 자원과 계절 초화 중심이라는 경관 특성의 차이를 확인하였다는 점에 방법적 의의가 있다.
향후 연구에서는 본 연구에서 확인된 경관의 구성 및 양적인 차이가 실제 방문 매력도와 재방문 의향으로 이어지는지를 설문조사 또는 평점 데이터와의 결합 분석을 통해 실증할 필요가 있다. 또한 본 연구에서 도입한 텍스트, 이미지 기반 자동화 분석 기술과 이미지에 대한 선호도 점수(라벨링)를 융합하여 각 경관 요소 및 구조가 방문객의 미적 체감 점수에 미치는 영향을 구체적으로 모델링하는 연구로 확장할 수 있을 것이다. 아울러 최근 고도화되고 있는 상용 멀티모달 대규모 언어모델과 본 연구에서 활용한 공개 모델 간의 경관 서술 성능을 비교·검증하는 연구 또한 후속 과제로 요구된다. 이러한 연구들의 축적은 중장기적으로 생성형 AI를 활용한 경관 계획·설계·관리 지원과 맞춤형 정원 경험 제공으로 발전할 수 있을 것으로 기대된다.


